MIT uczy agentów AI wymieniać pamięć podręczną KV zamiast tekstu
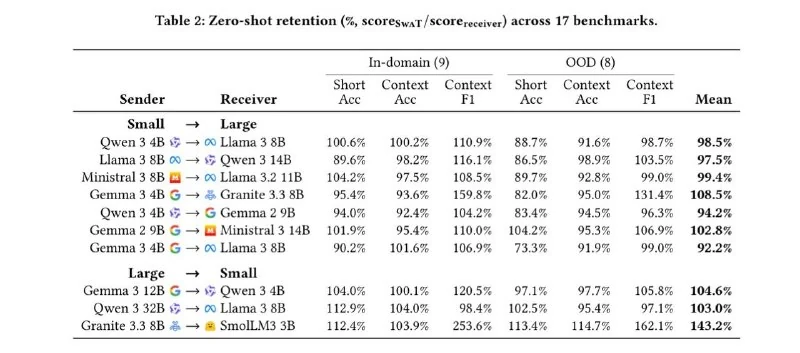
Badacze z MIT zaproponowali architekturę SwaT, która przekazuje przetworzony kontekst między modelami, ograniczając jego utratę i przyspieszając przepływy pracy agentów.
W systemach wieloagentowych kontekst musi być stale przekazywany między modelami. Na przykład, gdy jeden agent kończy swoją część zadania, a inny musi kontynuować pracę. Zwykle wykorzystuje się do tego podsumowania tekstowe, ale ich tworzenie i ponowne przetwarzanie wymaga dodatkowych obliczeń, a część informacji ginie.
Badacze zaproponowali architekturę SwaT (Swarm Telepathy), która pozwala przekazywać między modelami pamięć podręczną KV, czyli już przetworzony kontekst, zamiast tekstowych relacji. Działa to nawet między różnymi rodzinami modeli.
W benchmarkach SwaT w połączeniu z kompresją cache wykazał średnio o 40% wyższą jakość odpowiedzi i czterokrotne przyspieszenie w porównaniu z przekazywaniem podsumowań tekstowych. Co ciekawsze, tą metodą udało się przekazać informacje wizualne z modelu wizualno-językowego (VLM) do zwykłego modelu tekstowego.
Dlaczego to ważne
AnalizaZmniejsza redundancję obliczeń i utratę kontekstu w przepływach agentów oraz umożliwia efektywniejszą koordynację heterogenicznych modeli, w tym przesyłanie informacji wizualnych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Claude Code Projects: jak jeden AI koordynuje zespół autonomicznych agentów
Głęboka analiza Claude Code Projects: architektura Coordinator i Threads, równoległe gałęzie, wspólna pamięć MEMORY.md oraz zarządzanie agentami w chmurze.
Pamięć podręczna KV (Key-Value Cache)
Optymalizacja pamięci w modelach Transformer, która przechowuje wektory kluczy i wartości (Keys and Values) przetworzonych już tokenów w szybkiej pamięci GPU. Umożliwia natychmiastowe generowanie każdego kolejnego słowa, jednak jej rozmiar gwałtownie rośnie wraz z każdym nowym komunikatem w czacie.
PagedAttention i zarządzanie pamięcią podręczną KV
Algorytm zarządzania pamięcią GPU, który dzieli pamięć podręczną KV modelu językowego na nieciągłe strony wirtualne (analogicznie do jądra systemu operacyjnego), eliminując fragmentację i zwiększając przepustowość czterokrotnie.
Jev i System One AI: Kompletny praktyczny przewodnik po modelu decyzyjnym od TypeSafe
Głęboka analiza inżynieryjna flagowego modelu Jev: architektura System One w kontraście do LLM, prymitywy Choice/Score/Noul, równoległość zapytań, matematyka pewności, przypadki użycia wideo, kod oraz przegląd lokalnych alternatyw open-weight (Laya, GLiNER2.5, CLM-8B).