Sortie de Grok 4.7 : gains majeurs sur Terminal-Bench et CursorBench
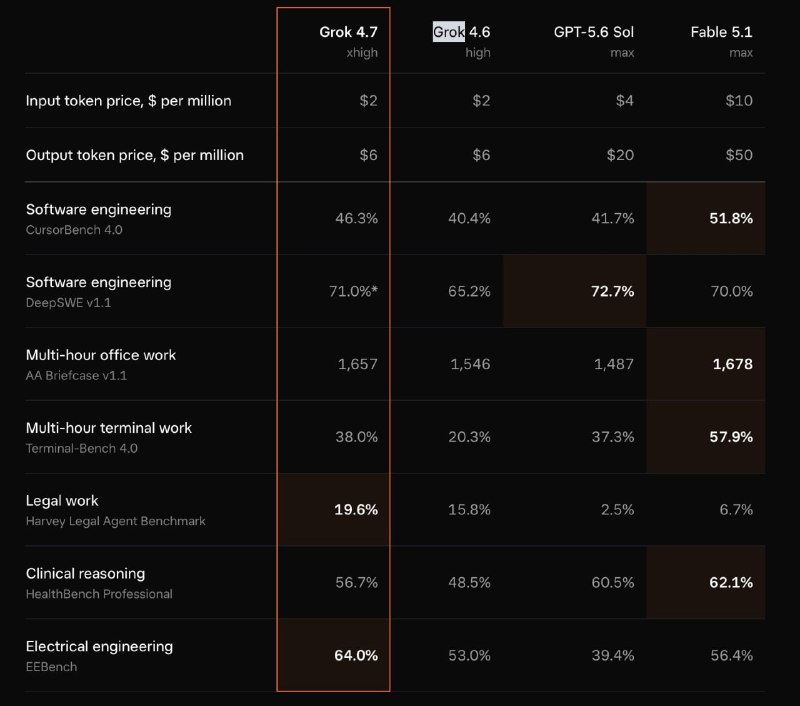
xAI a dévoilé Grok 4.7, doublant ses scores sur Terminal-Bench et dépassant GPT-5.6 Sol sur CursorBench, tout en maintenant sa tarification inchangée.
xAI a présenté Grok 4.7, la dernière itération de son modèle de langage. L'amélioration phare réside dans un bond significatif des performances sur le benchmark Terminal-Bench, où le score est passé de 20,3 % à 38 %.
Sur le test CursorBench, le modèle surpasse également GPT-5.6 Sol, avec un score de 46,3 % contre 41,7 %.
Fait notable, la structure tarifaire reste identique à celle de Grok 4.6, les coûts par token étant maintenus au même niveau.
Bien que Grok 4.7 soit encore en retrait par rapport à Fable 5.1 sur ces deux tests, ces progrès représentent une avancée sérieuse pour les capacités du modèle.
Annonce officielle : x.ai/news/grok-4-7
Pourquoi c'est important
AnalyseGrok 4.7 offre une performance doublée sur les tâches agentiques sans augmentation de prix, se positionnant ainsi comme un concurrent redoutable dans les domaines du codage et de l'automatisation.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Benchmarks pour agents : GAIA et SWE-bench
Nouvelle génération de benchmarks pratiques rigoureux pour évaluer l'autonomie de l'intelligence artificielle. GAIA teste des tâches multimodales sur le web ouvert avec fichiers et navigateur, tandis que SWE-bench vérifie la capacité des agents à trouver et corriger de vrais bugs dans de grands dépôts GitHub.
Évaluation des agents et benchmarking SWE-bench
Méthodologie et infrastructure pour la mesure systématique de la fiabilité, de la précision et de la sécurité des agents IA à l'aide de tests synthétiques, du benchmark SWE-bench et de simulations headless de dépôts.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.
Partie II. Architecture des agents IA : du modèle à la mémoire et aux outils
Immersion technique approfondie : tokenisation, cache KV, déterminisme de l'échantillonnage, stack d'entraînement, quantification, ingénierie contextuelle, stack de sécurité, RAG en production, ReAct et systèmes swarm multi-agents.