Sortie de Grok 4.7 : gains majeurs sur Terminal-Bench et CursorBench
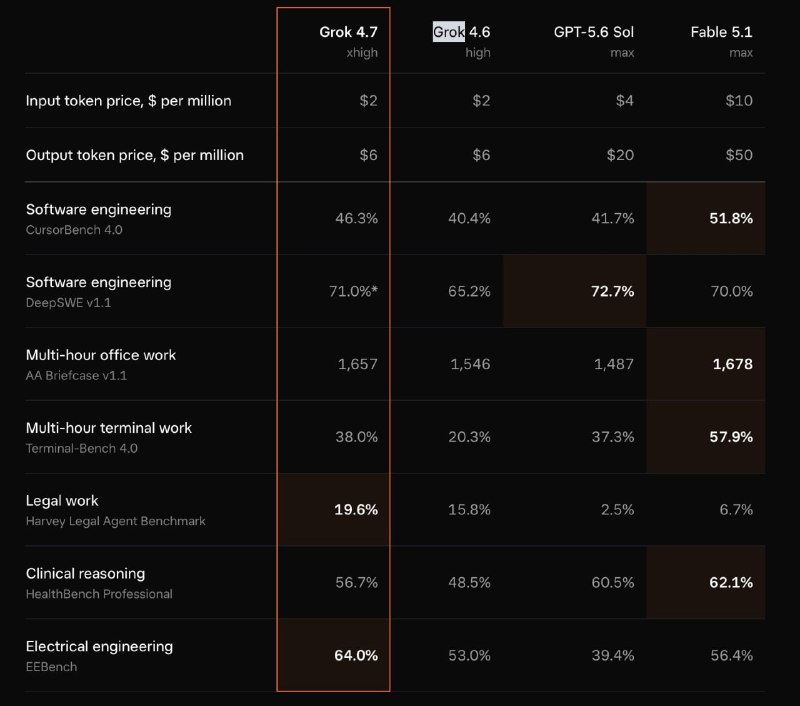
xAI a dévoilé Grok 4.7, doublant ses scores sur Terminal-Bench et dépassant GPT-5.6 Sol sur CursorBench, tout en maintenant sa tarification inchangée.
xAI a présenté Grok 4.7, la dernière itération de son modèle de langage. L'amélioration phare réside dans un bond significatif des performances sur le benchmark Terminal-Bench, où le score est passé de 20,3 % à 38 %.
Sur le test CursorBench, le modèle surpasse également GPT-5.6 Sol, avec un score de 46,3 % contre 41,7 %.
Fait notable, la structure tarifaire reste identique à celle de Grok 4.6, les coûts par token étant maintenus au même niveau.
Bien que Grok 4.7 soit encore en retrait par rapport à Fable 5.1 sur ces deux tests, ces progrès représentent une avancée sérieuse pour les capacités du modèle.
Annonce officielle : x.ai/news/grok-4-7
Pourquoi c'est important
AnalyseGrok 4.7 offre une performance doublée sur les tâches agentiques sans augmentation de prix, se positionnant ainsi comme un concurrent redoutable dans les domaines du codage et de l'automatisation.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs