Grok 4.7 veröffentlicht: Deutliche Leistungssteigerungen in Terminal-Bench und CursorBench
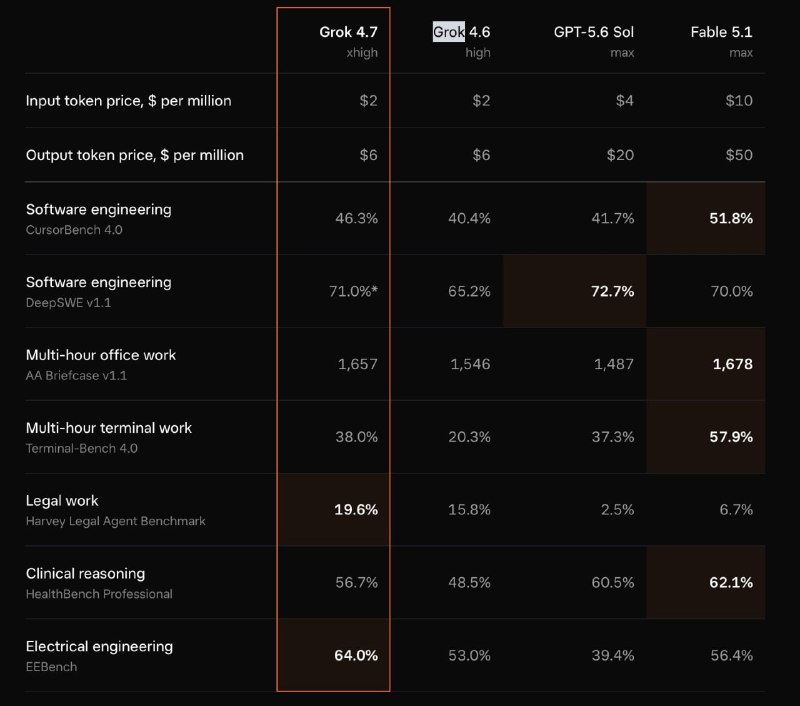
xAI hat Grok 4.7 vorgestellt, das mit verdoppelten Werten im Terminal-Bench und einer Führung gegenüber GPT-5.6 Sol im CursorBench überzeugt – bei unverändertem Preis.
xAI hat Grok 4.7 enthüllt, die neueste Iteration seines Sprachmodells. Die wichtigste Verbesserung ist ein erheblicher Leistungssprung im Terminal-Bench, wo sich die Ergebnisse von 20,3 % auf 38 % gesteigert haben.
Im CursorBench-Test übertrifft das Modell zudem GPT-5.6 Sol mit einer Punktzahl von 46,3 % gegenüber 41,7 %.
Bemerkenswert ist, dass die Preisstruktur im Vergleich zu Grok 4.6 unverändert bleibt; die Token-Kosten sind gleich geblieben.
Obwohl Grok 4.7 in beiden Tests noch hinter Fable 5.1 liegt, stellen diese Zuwächse einen bedeutenden Fortschritt für die Fähigkeiten des Modells dar.
Offizielle Ankündigung: x.ai/news/grok-4-7
Warum das wichtig ist
AnalyseGrok 4.7 liefert doppelte Leistung bei agentischen Aufgaben ohne Preiserhöhung und positioniert sich damit als starker Wettbewerber im Bereich Coding und Automatisierung.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern