Premiera Grok 4.7: Znaczny wzrost wyników w Terminal-Bench i CursorBench
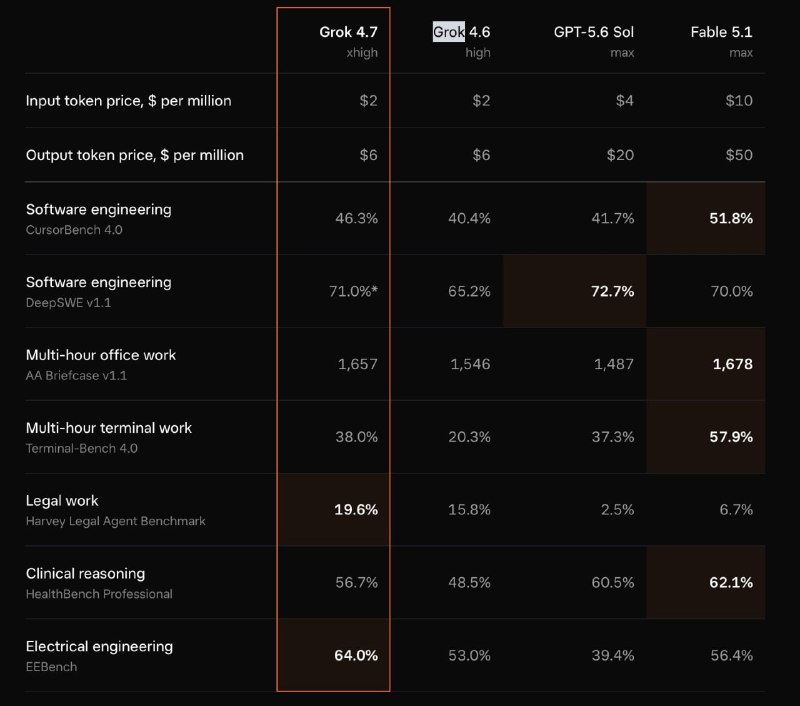
xAI udostępniło model Grok 4.7, który dwukrotnie poprawił wyniki w teście Terminal-Bench i wyprzedził GPT-5.6 Sol w benchmarku CursorBench, zachowując przy tym dotychczasową cennik.
Firma xAI zaprezentowała Grok 4.7, najnowszą iterację swojego modelu językowego. Kluczową innowacją jest znaczący skok wydajności w teście Terminal-Bench, gdzie wynik wzrósł z 20,3% do 38%.
W ramach testu CursorBench nowy model również okazuje się lepszy od GPT-5.6 Sol, osiągając wynik 46,3% w porównaniu do 41,7%.
Co istotne, struktura cenowa pozostaje bez zmian względem wersji Grok 4.6, a koszty za tokeny nie uległy podwyższeniu.
Mimo że Grok 4.7 wciąż ustępuje miejsca modelowi Fable 5.1 w obu wspomnianych testach, uzyskane postępy stanowią poważny krok naprzód dla możliwości tej technologii.
Oficjalne ogłoszenie: x.ai/news/grok-4-7
Dlaczego to ważne
AnalizaGrok 4.7 oferuje dwukrotny wzrost wydajności w zadaniach agentowych bez podnoszenia cen, co umieszcza go w roli silnego konkurenta na rynku narzędzi do programowania i automatyzacji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Benchmarki dla agentów: GAIA i SWE-bench
Nowe pokolenie rygorystycznych, praktycznych benchmarków służących do oceny autonomii sztucznej inteligencji. GAIA testuje zadania multimodalne w otwartym internecie z wykorzystaniem plików i przeglądarki, natomiast SWE-bench sprawdza zdolność agentów do znajdowania i naprawiania rzeczywistych błędów w dużych repozytoriach GitHub.
Ocena agentów i benchmarking SWE-bench
Metodologia i infrastruktura systematycznego pomiaru niezawodności, dokładności i bezpieczeństwa agentów AI przy użyciu testów syntetycznych, SWE-bench oraz symulacji repozytoriów w trybie headless.
Część I. Architektura agentów AI: fundamentalne elementy
Dziesięć fundamentalnych elementów współczesnego agenta: taksonomia modeli, pętla runtime, techniki promptowania, destylacja, umiejętności (skills), pamięć, wywoływanie funkcji oraz ekonomia jednostkowa.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.