OpenAI dévoile sa propre puce « Jalapeño » pour les LLM
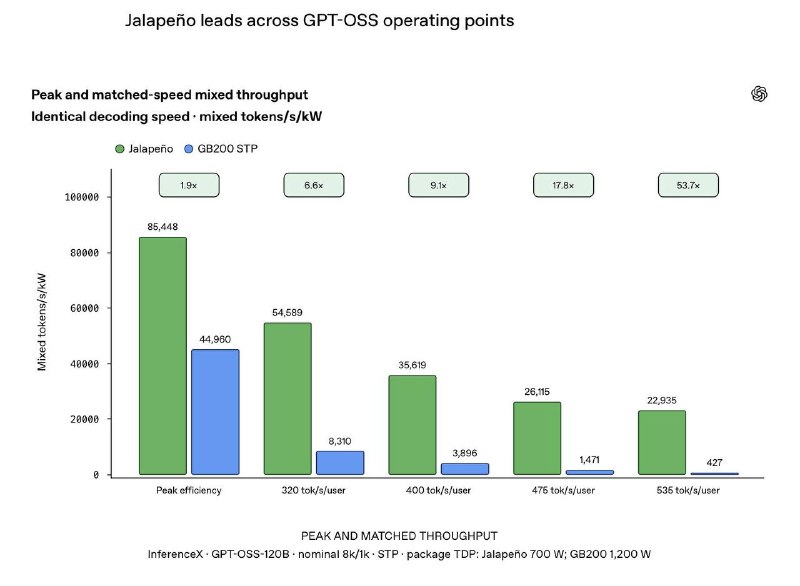
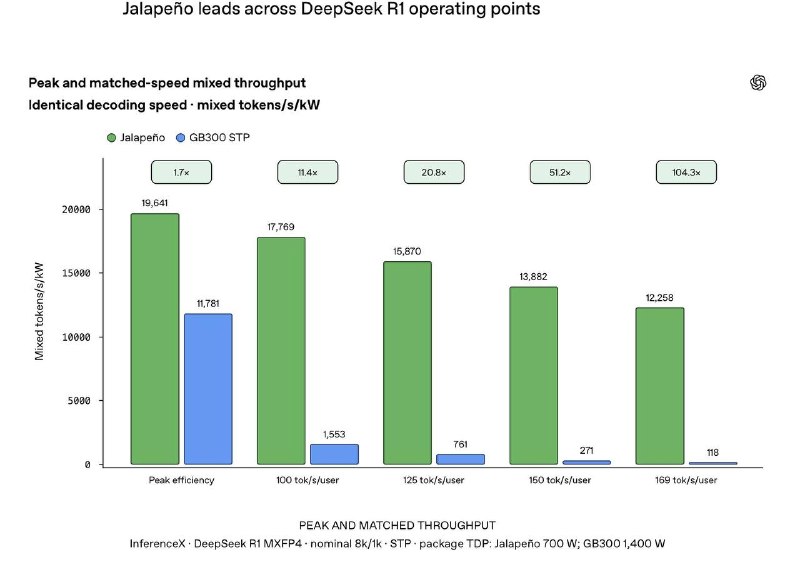
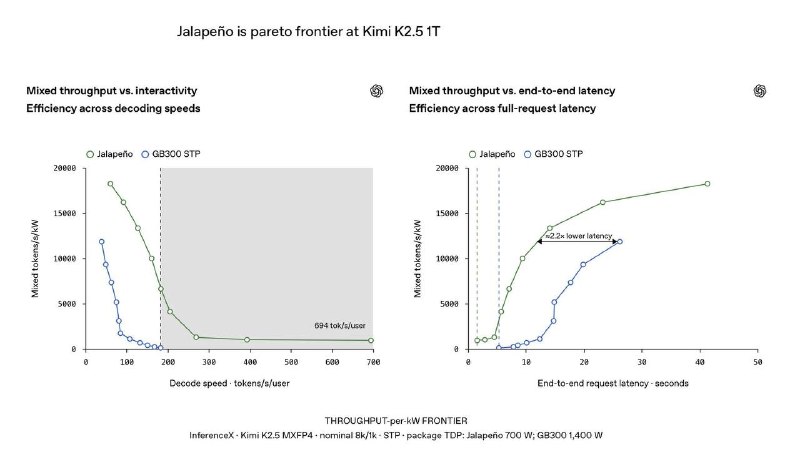
OpenAI, en partenariat avec Broadcom, a conçu la puce Jalapeño, dédiée à l'inférence des grands modèles de langage. Elle promet des performances jusqu'à 4,1 fois supérieures à celles des puces Nvidia.
OpenAI dévoile sa propre puce « Jalapeño » pour les LLM
OpenAI, en collaboration avec Broadcom, a développé une nouvelle puce baptisée Jalapeño, spécifiquement conçue pour l'inférence des grands modèles de langage (LLM) et des systèmes associés tels que Codex.
Actuellement en phase de test, la puce affiche déjà des résultats préliminaires prometteurs. Selon ces données, Jalapeño surpasse les puces GB200 et GB300 de Nvidia en termes de vitesse et d'efficacité énergétique. Pour les charges de travail à forte interactivité, les performances du nouveau composant seraient multipliées par un facteur allant de 2,1 à 4,1.
Le déploiement opérationnel de cette puce est prévu pour la fin de l'année 2026.
Pourquoi c'est important
AnalyseCette innovation pourrait redessiner le marché du traitement de données en offrant une puissance accrue aux grands modèles de langage. Elle illustre également l'intensification de la concurrence entre les géants technologiques dans le secteur de l'intelligence artificielle.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Quatre conseils de CV du responsable du développement IA appliquée chez OpenAI
Wulfie Bain, responsable du développement IA appliquée chez OpenAI, a partagé quatre règles : brièveté, pertinence, mise en avant des résultats et réalisations clés en premier.
AI Radar : GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 et changements tarifaires d’OpenAI et d’Anthropic
Tour d’horizon des actualités IA : nouveaux modèles LLM, changements d’abonnements OpenAI et Anthropic, modèles de monde, générateurs vidéo et détails d’entreprise.
Codex Skills pour débutants : comment automatiser les scénarios de travail des agents IA
Guide pratique pour créer et utiliser les Skills dans Codex : anatomie du fichier SKILL.md, activation explicite et automatique, différences entre les compétences, les scripts et les outils, l'API Skills et la configuration des limites de sécurité.
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.