OpenAI dévoile sa propre puce « Jalapeño » pour les LLM
OpenAI, en partenariat avec Broadcom, a conçu la puce Jalapeño, dédiée à l'inférence des grands modèles de langage. Elle promet des performances jusqu'à 4,1 fois supérieures à celles des puces Nvidia.
OpenAI dévoile sa propre puce « Jalapeño » pour les LLM
OpenAI, en collaboration avec Broadcom, a développé une nouvelle puce baptisée Jalapeño, spécifiquement conçue pour l'inférence des grands modèles de langage (LLM) et des systèmes associés tels que Codex.
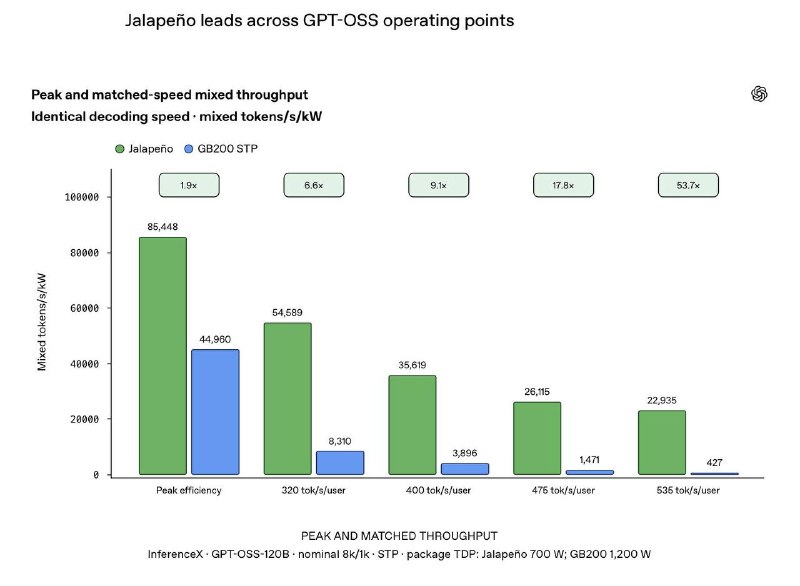
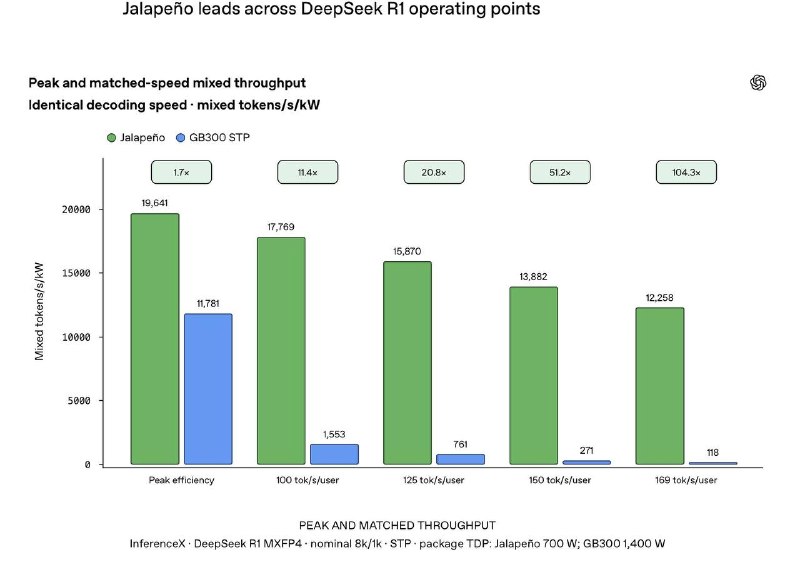
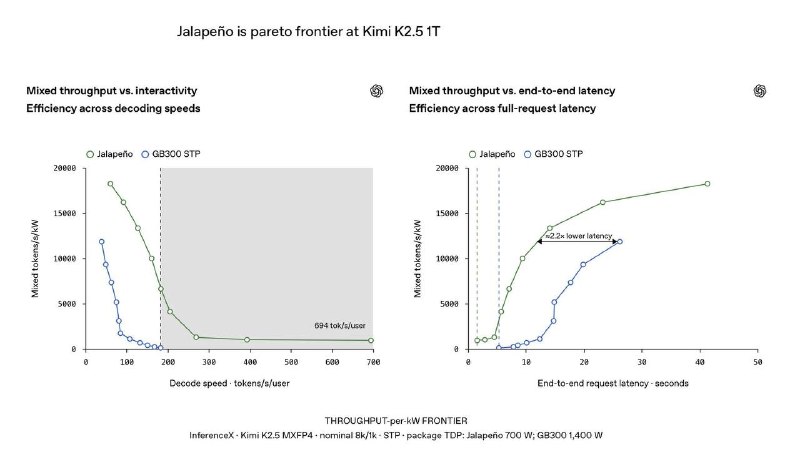
Actuellement en phase de test, la puce affiche déjà des résultats préliminaires prometteurs. Selon ces données, Jalapeño surpasse les puces GB200 et GB300 de Nvidia en termes de vitesse et d'efficacité énergétique. Pour les charges de travail à forte interactivité, les performances du nouveau composant seraient multipliées par un facteur allant de 2,1 à 4,1.
Le déploiement opérationnel de cette puce est prévu pour la fin de l'année 2026.
Pourquoi c'est important
AnalyseCette innovation pourrait redessiner le marché du traitement de données en offrant une puissance accrue aux grands modèles de langage. Elle illustre également l'intensification de la concurrence entre les géants technologiques dans le secteur de l'intelligence artificielle.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs