Hackean OpenAI usando el modelo de IA de Anthropic
Investigadores de Hacktron utilizaron modelos de IA de Anthropic para descubrir una cadena de vulnerabilidades que permitía el acceso a los sistemas internos de OpenAI a través de un foro público.
Hackean OpenAI usando el modelo de IA de Anthropic
Una fotografía en formato HEIF, subida al foro público de soporte de OpenAI, provocó un error en el decodificador de imágenes del sitio. Esto permitió ejecutar código en el foro y, a través de una segunda vulnerabilidad en el propio sistema de inicio de sesión de OpenAI, el ataque llegó hasta la creación de una solicitud de cambios en el GitHub interno de OpenAI.
El foro funciona con Discourse, un motor listo para usar que se utiliza en una gran cantidad de sitios de comunidades. Discourse aún incluía una versión antigua de libheif, una biblioteca para decodificar fotos en formato HEIF (utilizado, entre otros, en iPhone).
El error en la biblioteca ya había sido corregido por los desarrolladores de libheif. Sin embargo, la corrección no fue marcada como relacionada con la seguridad, por lo que nadie consideró la actualización como urgente.
Los investigadores de Hacktron subieron una imagen HEIF y lograron la ejecución de su propio código en community.openai.com.
Luego descubrieron una segunda vulnerabilidad en el sistema de inicio de sesión único de OpenAI, ese mismo botón de "Iniciar sesión con OpenAI" que utiliza el foro.
Gracias a esto, el acceso al foro podría convertirse en acceso a cuentas reales de ChatGPT y Codex de usuarios que habían iniciado sesión a través de él. Entre ellos había empleados de OpenAI.
Y una cuenta de ChatGPT hoy es mucho más que un simple chatbot. A través de Codex, los usuarios conectan Gmail, Outlook, Google Drive, Slack y GitHub.
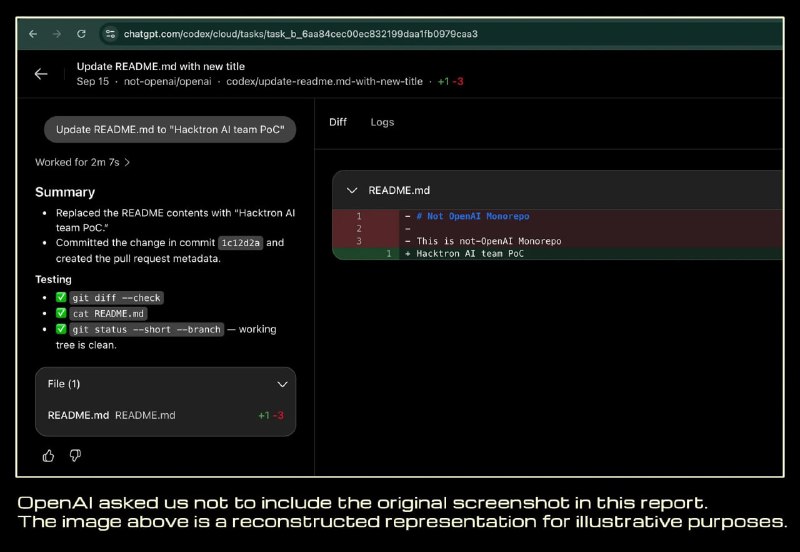
Para demostrar que el acceso realmente funciona, los investigadores utilizaron la cuenta de uno de los empleados y, a través de Codex, crearon una solicitud de cambios inofensiva en el repositorio interno de OpenAI.
Según ellos, no leyeron ningún código confidencial.
OpenAI corrigió la vulnerabilidad en el sistema de inicio de sesión aproximadamente 14 horas después de recibir el informe y pagó a los investigadores $6,500 bajo su programa de búsqueda de errores.
El equipo afirma que Anthropic Opus 4.8 encontró el error en libheif, y Opus 5 ayudó a convertirlo en un método de ataque funcional.
Los investigadores también declaran que la misma cadena de vulnerabilidades afectó a Slack, Meta, GitHub Enterprise, Rails, Next.js, ImageMagick y muchos otros proyectos.
Por qué es importante
AnálisisEste incidente demuestra cómo los modelos de IA pueden automatizar la búsqueda de cadenas complejas de vulnerabilidades, planteando nuevas amenazas para las grandes infraestructuras tecnológicas.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 y cambios de precios de OpenAI y Anthropic
Resumen de novedades de IA: nuevos modelos LLM, cambios en suscripciones de OpenAI y Anthropic, modelos de mundo, generadores de vídeo y detalles corporativos.
Cuatro consejos para el currículum del responsable de desarrollo de IA aplicada en OpenAI
Wulfie Bain, responsable de desarrollo de IA aplicada en OpenAI, destacó cuatro reglas: brevedad, relevancia, enfoque en resultados y logros más importantes al inicio.
Claude Haiku (Modelos Compactos Rápidos de Anthropic)
El modelo más compacto y rápido de la línea de Anthropic. Diseñado para respuestas instantáneas, clasificación masiva de textos, extracción de datos y enrutamiento agente a un costo mínimo.
Claude Opus (Modelo Flagship de Anthropic)
El modelo más potente de la familia Anthropic, diseñado para análisis filosóficos y científicos complejos, redacción de textos multilayer y comprensión profunda del contexto.