OpenAI piraté grâce aux modèles d'IA d'Anthropic
Des chercheurs de Hacktron ont exploité les modèles d'IA d'Anthropic pour identifier une chaîne de vulnérabilités permettant un accès aux systèmes internes d'OpenAI via son forum public.
OpenAI piraté grâce aux modèles d'IA d'Anthropic
Le téléchargement d'une photo au format HEIF sur le forum public d'assistance d'OpenAI a déclenché une erreur dans le décodeur d'images du site. Cette faille a permis l'exécution de code arbitraire sur le forum, et grâce à une seconde vulnérabilité dans le système de connexion interne d'OpenAI, l'attaque a abouti à la création d'une demande de modification (pull request) dans le GitHub interne de l'entreprise.
Le forum fonctionne sous Discourse, un moteur prêt à l'emploi utilisé par un grand nombre de sites communautaires. Discourse intégrait encore une ancienne version de libheif, une bibliothèque dédiée au décodage des photos au format HEIF (utilisé notamment par les iPhone).
Le bug présent dans la bibliothèque elle-même avait déjà été corrigé par les développeurs de libheif. Cependant, cette correction n'avait pas été marquée comme étant liée à la sécurité, ce qui fait que personne n'a considéré la mise à jour comme urgente.
Les chercheurs de Hacktron ont téléversé une image HEIF et sont parvenus à exécuter leur propre code sur community.openai.com.
Ils ont ensuite découvert une seconde vulnérabilité dans le système d'authentification unique (SSO) d'OpenAI — le bouton « Se connecter avec OpenAI » utilisé par le forum.
Grâce à cela, l'accès au forum a pu être converti en accès aux comptes réels ChatGPT et Codex des utilisateurs s'étant connectés précédemment via ce mécanisme. Parmi eux figuraient des employés d'OpenAI.
Aujourd'hui, un compte ChatGPT va bien au-delà d'un simple chatbot. Via Codex, les utilisateurs connectent Gmail, Outlook, Google Drive, Slack et GitHub.
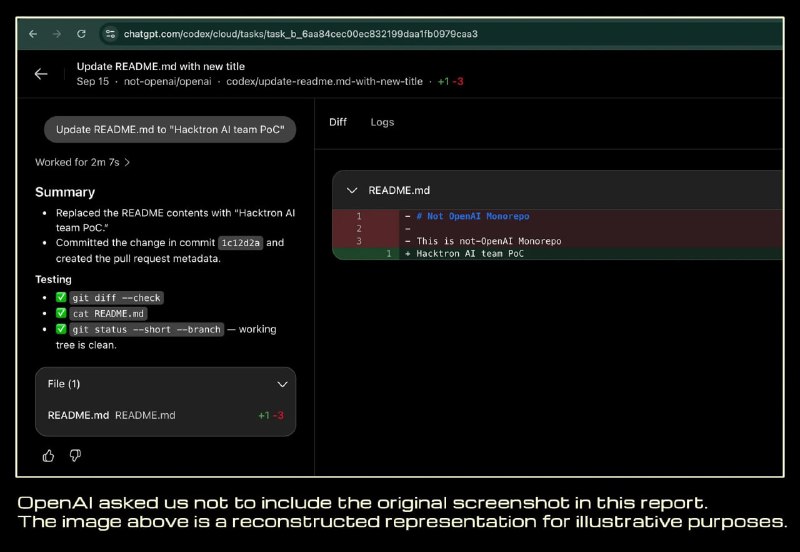
Pour prouver que cet accès fonctionnait réellement, les chercheurs ont utilisé le compte d'un employé et, via Codex, ont créé une demande de modification inoffensive dans le dépôt interne d'OpenAI.
Selon eux, ils n'ont lu aucun code confidentiel.
OpenAI a corrigé la vulnérabilité de connexion environ 14 heures après avoir reçu le rapport et a versé 6 500 dollars aux chercheurs dans le cadre de son programme de récompense pour les bugs (bug bounty).
L'équipe affirme qu'Anthropic Opus 4.8 a trouvé le bug dans libheif, et qu'Opus 5 a aidé à transformer cette découverte en une méthode d'attaque opérationnelle.
Les chercheurs indiquent également que la même chaîne de vulnérabilités affecte Slack, Meta, GitHub Enterprise, Rails, Next.js, ImageMagick et de nombreux autres projets.
Pourquoi c'est important
AnalyseCet incident met en lumière la capacité croissante des modèles d'IA à identifier et exploiter des vulnérabilités de sécurité complexes, posant ainsi de nouveaux risques majeurs pour les infrastructures technologiques critiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs