OpenAI зламали за допомогою моделі Anthropic: як ШІ знайшов критичну вразливість
Дослідники з Hacktron використали моделі ШІ від Anthropic для пошуку вразливостей, що дозволило отримати доступ до внутрішніх систем OpenAI через публічний форум.
OpenAI зламали за допомогою моделі Anthropic
Фотографія у форматі HEIF, завантажена на публічний форум підтримки OpenAI, викликала помилку в декодері зображень сайту. Це дозволило виконати код на форумі, а через другу вразливість у власній системі входу OpenAI атака досягла створення запиту на зміни у внутрішньому GitHub OpenAI.
Форум працює на Discourse — готовому рушії, який використовується на великій кількості сайтів спільнот. У Discourse досі поставлялася стара версія libheif — бібліотеки для декодування фото у форматі HEIF (який використовується, зокрема, на iPhone).
Саму помилку в бібліотеці вже виправили розробники libheif. Але виправлення не було позначено як пов'язане з безпекою, тому ніхто не вважав оновлення терміновим.
Дослідники з Hacktron завантажили HEIF-зображення та домоглися виконання власного коду на community.openai.com.
Потім вони виявили другу вразливість у системі єдиного входу OpenAI — тій самій кнопці «Увійти через OpenAI», яку використовує форум.
Завдяки цьому доступ до форуму можна було перетворити на доступ до реальних акаунтів ChatGPT та Codex користувачів, які раніше входили через нього. Серед них були й співробітники OpenAI.
А акаунт ChatGPT сьогодні — це далеко не просто чат-бот. Через Codex користувачі підключають Gmail, Outlook, Google Drive, Slack та GitHub.
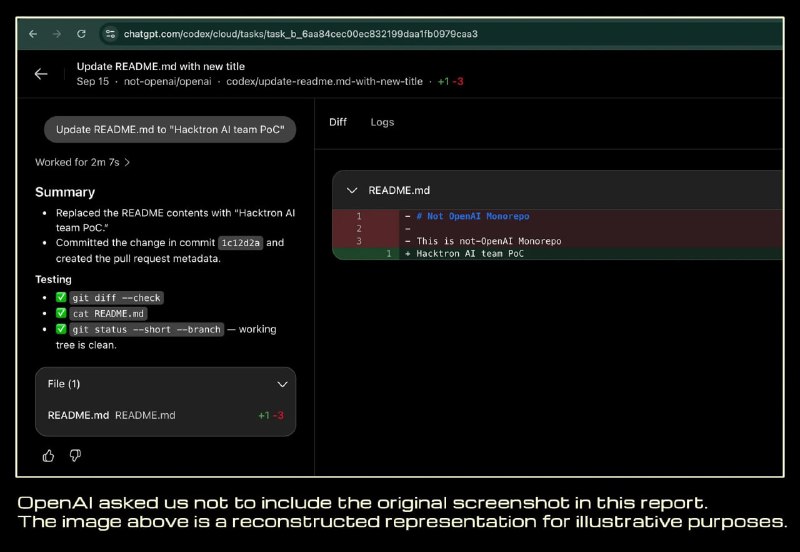
Щоб довести, що доступ дійсно працює, дослідники використали акаунт одного зі співробітників і через Codex створили безпечний запит на зміни у внутрішньому репозиторії OpenAI.
За їхніми словами, жодного конфіденційного коду вони не читали.
OpenAI виправила вразливість у системі входу приблизно через 14 годин після отримання звіту та виплатила дослідникам $6 500 за програмою пошуку вразливостей.
Команда стверджує, що Anthropic Opus 4.8 виявила помилку в libheif, а Opus 5 допомогла перетворити її на робочий спосіб атаки.
Дослідники також заявляють, що тією ж ланцюжком вразливостей були затронуті Slack, Meta, GitHub Enterprise, Rails, Next.js, ImageMagick та багато інших проєктів.
Чому це важливо
АналітикаЦей кейс демонструє, як ШІ-моделі можуть автоматизувати пошук складних ланцюжків вразливостей у реальному часі, ставлячи під загрозу навіть захищені екосистеми великих технологічних компаній.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 і зміни тарифів OpenAI та Anthropic
Огляд свіжих новин AI: оновлення великих мовних моделей, зміни підписок OpenAI та Anthropic, а також нові world-моделі, відеогенератори й корпоративні фінансові деталі.
Чотири поради щодо резюме від керівника напрямку прикладного ШІ в OpenAI
Керівник напрямку прикладної розробки ШІ в OpenAI Вульфі Бейн назвав чотири ключові правила резюме: стислість, релевантність, акцент на результатах і правильний порядок досягнень.
Claude Haiku (Швидкісні компактні моделі Anthropic)
Найкомпактніша та найшвидша модель у лінійці Anthropic. Створена для блискавичних відповідей, масової класифікації текстів, витягування даних та агентської маршрутизації за мінімальну вартість.
OpenAI GPT (Флагманські моделі серії GPT)
Головна універсальна лінійка великих мовних моделей від OpenAI (GPT-4, GPT-4o). Оптимізована для складного текстового аналізу, програмування, творчості та щоденної інтелектуальної роботи.