OpenAI zhakowane przy użyciu modelu AI Anthropic
Badacze z Hacktron wykorzystali modele sztucznej inteligencji Anthropic do wykrycia łańcucha podatności, który umożliwił dostęp do wewnętrznych systemów OpenAI poprzez publiczne forum wsparcia.
OpenAI zhakowane przy użyciu modelu AI Anthropic
Zdjęcie w formacie HEIF przesłane na publiczne forum wsparcia OpenAI wywołało błąd w dekoderze obrazów witryny. Pozwoliło to na wykonanie kodu na forum, a dzięki drugiej luce w systemie logowania OpenAI atak doprowadził do utworzenia żądania zmiany (pull request) w wewnętrznym repozytorium GitHub firmy.
Forum działa w oparciu o Discourse, gotowy silnik używany przez ogromną liczbę serwisów społecznościowych. Discourse wciąż zawierał starą wersję biblioteki libheif, służącej do dekodowania zdjęć w formacie HEIF (m.in. na iPhone’ach).
Błąd w samej bibliotece został już naprawiony przez deweloperów libheif. Jednak poprawka nie została oznaczona jako związana z bezpieczeństwem, więc nikt nie uznał aktualizacji za pilną.
Badacze z Hacktron przesłali obraz HEIF i osiągnęli wykonanie własnego kodu na community.openai.com.
Następnie odkryli drugą lukę w systemie pojedynczego logowania (SSO) OpenAI – czyli przycisku „Login with OpenAI” używanym przez forum.
Dzięki temu dostęp do forum można było przekształcić w dostęp do rzeczywistych kont ChatGPT i Codex użytkowników, którzy wcześniej się przez nie logowali. Wśród nich byli pracownicy OpenAI.
Konto ChatGPT jest dziś czymś znacznie więcej niż tylko chatbotem. Poprzez Codex użytkownicy łączą Gmaila, Outlooka, Google Drive, Slacka i GitHuba.
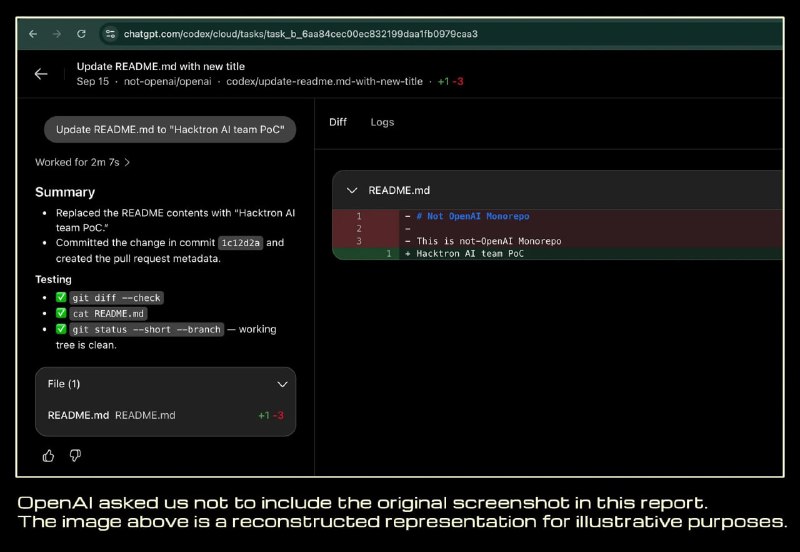
Aby udowodnić, że dostęp faktycznie działa, badacze wykorzystali konto jednego z pracowników i za pośrednictwem Codex stworzyli nieszkodliwe żądanie zmiany w wewnętrznym repozytorium OpenAI.
Według ich słów nie czytali żadnego poufnego kodu.
OpenAI naprawiło lukę w systemie logowania około 14 godzin po otrzymaniu raportu i wypłaciło badaczom 6500 dolarów w ramach programu bug bounty.
Zespół twierdzi, że Anthropic Opus 4.8 znalazł błąd w libheif, a Opus 5 pomógł przekształcić go w działającą metodę ataku.
Badacze wskazują również, że ten sam łańcuch podatności dotyczył Slacka, Meta, GitHub Enterprise, Rails, Next.js, ImageMagick i wielu innych projektów.
Dlaczego to ważne
AnalizaIncydent podkreśla rosnącą zdolność modeli AI do identyfikowania i wykorzystywania złożonych luk bezpieczeństwa, co stwarza nowe zagrożenia dla infrastruktury technologicznej największych firm.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 i zmiany cen OpenAI oraz Anthropic
Przegląd najnowszych wiadomości AI: nowe modele LLM, zmiany subskrypcji OpenAI i Anthropic, modele świata, generatory wideo oraz szczegóły korporacyjne.
Cztery wskazówki do CV od szefa rozwoju zastosowań AI w OpenAI
Wulfie Bain, szef rozwoju zastosowań AI w OpenAI, wskazał cztery zasady: zwięzłość, trafność, nacisk na wyniki i najważniejsze osiągnięcia na początku.
Przycisk zatwierdzenia przez człowieka (Human-in-the-Loop / HITL)
Wzorzec architektoniczny bezpieczeństwa autonomicznych agentów (Human-in-the-Loop), który wprowadza punkty kontrolne (Approval Gates) przed wykonaniem krytycznych operacji. Agent przygotowuje akcję (np. płatność, usunięcie bazy danych, wysłanie wiadomości do klienta), ale wstrzymuje jej realizację do momentu wyraźnego zatwierdzenia przez żywego człowieka.
Claude Haiku (Szybkie, kompaktowe modele Anthropic)
Najmniejszy i najszybszy model w ofercie Anthropic. Zaprojektowany do błyskawicznych odpowiedzi, masowej klasyfikacji tekstu, ekstrakcji danych oraz routingu agentowego przy minimalnych kosztach.