Apareció un nuevo benchmark
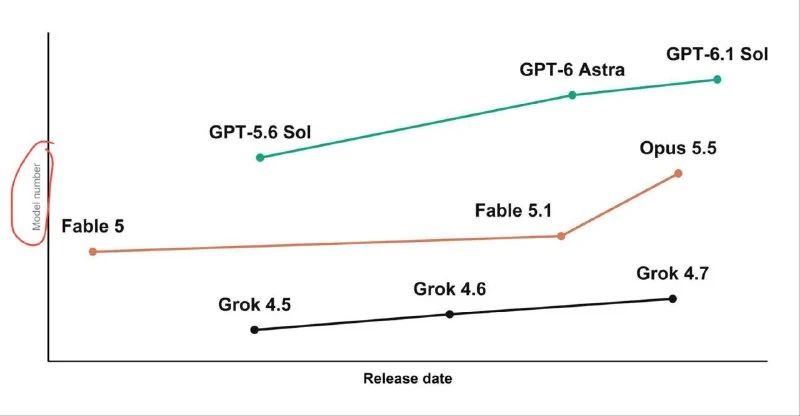
Un nuevo benchmark apareció sin detalles publicados sobre el modelo o las métricas.
Apareció un nuevo benchmark sin detalles publicados.
La publicación no incluye enlaces a un repositorio, artículo, modelo o métricas, por lo que aún no es posible evaluar su relevancia ni su fiabilidad.
Por qué es importante
AnálisisLos benchmarks ayudan a evaluar el progreso de la IA, pero sin fuente ni métricas no se puede valorar la calidad de la prueba.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
GPT-6.2 Astra: más ejemplos de generación 3D
GPT-6.2 Astra muestra escenas 3D, incluidas recreaciones de Vice City y Rick Astley, mientras que las consultas complejas pueden consumir rápidamente los límites de suscripción.
Benchmarks para Agentes: GAIA y SWE-bench
Nueva generación de rigurosos benchmarks prácticos para evaluar la autonomía de la inteligencia artificial. GAIA prueba tareas multimodales en la web abierta con archivos y navegador, mientras que SWE-bench evalúa la capacidad de los agentes para encontrar y corregir errores reales en grandes repositorios de GitHub.
Evaluaciones de Agentes y Benchmarking SWE-bench
Metodología e infraestructura para la medición sistemática de la fiabilidad, precisión y seguridad de los agentes de IA mediante pruebas sintéticas, SWE-bench y simulaciones de repositorios sin cabeza.