Un nouveau benchmark fait son apparition sans détails divulgués
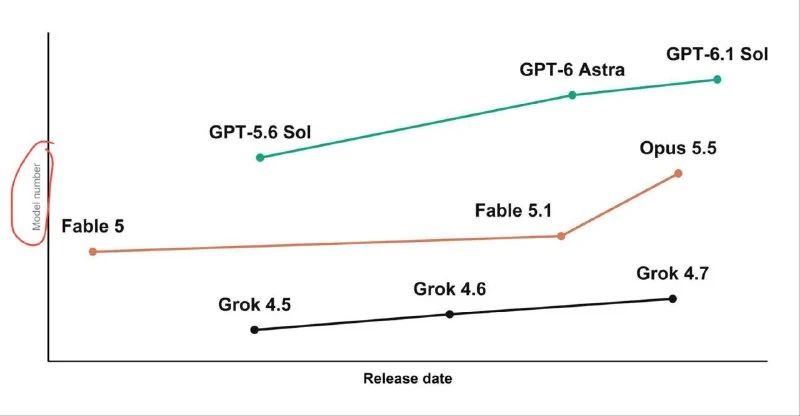
Un nouveau benchmark a été publié, mais aucune information sur le modèle ou les métriques n'a été fournie. Son utilité et sa fiabilité restent donc indéterminées.
Un nouveau benchmark est apparu récemment, mais il manque des informations essentielles.
La publication ne contient aucun lien vers un dépôt de code, un article scientifique, un modèle spécifique ou des métriques détaillées. Par conséquent, la pertinence et la fiabilité de ce test ne peuvent pas encore être évaluées.
Pourquoi c'est important
AnalyseLes benchmarks sont cruciaux pour suivre les progrès de l'IA, mais sans source ni métriques claires, il est impossible d'évaluer la qualité réelle du test.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro : Comparaison des modèles 2026
Chaque semaine ou presque, un nouveau modèle est lancé, et les mêmes questions reviennent inlassablement : faut-il changer de solution ? Qu'est-ce qui a évolué ? Pour quoi payer ?
GPT-6.2 Astra : d'autres exemples de génération 3D
GPT-6.2 Astra montre des scènes 3D, dont des recréations de Vice City et de Rick Astley, tandis que les requêtes complexes peuvent épuiser rapidement les limites d'abonnement.
Benchmarks pour agents : GAIA et SWE-bench
Nouvelle génération de benchmarks pratiques rigoureux pour évaluer l'autonomie de l'intelligence artificielle. GAIA teste des tâches multimodales sur le web ouvert avec fichiers et navigateur, tandis que SWE-bench vérifie la capacité des agents à trouver et corriger de vrais bugs dans de grands dépôts GitHub.
Évaluation des agents et benchmarking SWE-bench
Méthodologie et infrastructure pour la mesure systématique de la fiabilité, de la précision et de la sécurité des agents IA à l'aide de tests synthétiques, du benchmark SWE-bench et de simulations headless de dépôts.