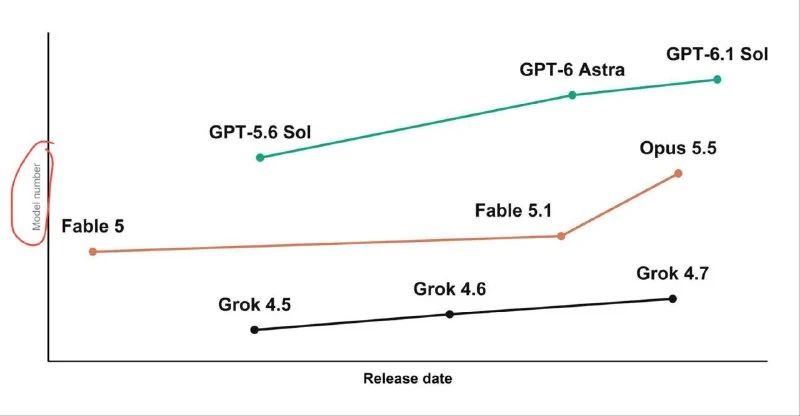
Новый бенчмарк появился без раскрытых деталей о модели и метриках.
Дропнули новый бенчмарк.
Почему это важно
АналитикаБенчмарки помогают оценивать прогресс ИИ, но без источника и метрик нельзя делать выводы о качестве теста.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: сравнение моделей 2026
Каждые несколько недель выходит новая модель, и каждый раз те же вопросы: стоит ли переходить? что изменилось? за что платить?
GPT-6.2 Astra: ещё примеры 3D-генерации
Модель GPT-6.2 Astra демонстрирует 3D-сцены, включая воссоздание Вайс-Сити и Рика Астли, но сложные запросы могут быстро исчерпать лимиты подписки.
Бенчмарки для агентов: GAIA и SWE-bench
Новое поколение строгих практических бенчмарков для оценки автономности искусственного интеллекта. GAIA тестирует мультимодальные задачи в открытом вебе с файлами и браузером, а SWE-bench проверяет способность агентов находить и исправлять настоящие баги в больших репозиториях GitHub.
Оценка Агентов и Бенчмаркинг SWE-bench
Методология и инфраструктура систематического измерения надежности, точности и безопасности ИИ-агентов с помощью синтетических тестов, SWE-bench и headless репозиторных симуляций.