Nowy benchmark bez ujawnionych szczegółów
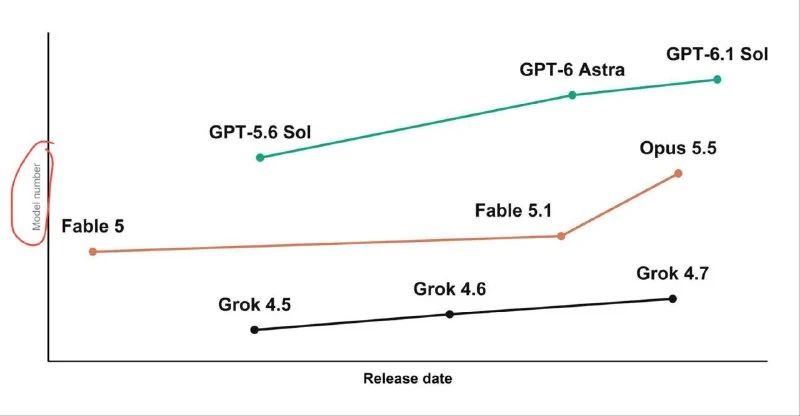
W sieci pojawił się nowy benchmark AI, jednak brak kluczowych informacji o modelu i metrykach uniemożliwia jego weryfikację.
Brak transparentności
Ogłoszenie nowego benchmarku nie zawierało żadnych istotnych danych technicznych. W publikacji zabrakło linków do repozytorium, artykułu naukowego, opisu modelu czy definicji metryk oceniających.
Niepewna wiarygodność
Ze względu na brak źródła i metodologii, aktualna przydatność oraz rzetelność tego zestawu testowego pozostają niemożliwe do oszacowania.
Dlaczego to ważne
AnalizaChoć benchmarki są kluczowe dla śledzenia postępów w sztucznej inteligencji, ich wartość zależy od pełnej przejrzystości. Bez dostępu do źródeł i metryk nie da się zweryfikować jakości ani wiarygodności testu.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
GPT-6.2 Astra: kolejne przykłady generowania 3D
GPT-6.2 Astra pokazuje sceny 3D, w tym odtworzenie Vice City i Ricka Astleya, a złożone prompty mogą szybko wyczerpywać limity subskrypcji.
Benchmarki dla agentów: GAIA i SWE-bench
Nowe pokolenie rygorystycznych, praktycznych benchmarków służących do oceny autonomii sztucznej inteligencji. GAIA testuje zadania multimodalne w otwartym internecie z wykorzystaniem plików i przeglądarki, natomiast SWE-bench sprawdza zdolność agentów do znajdowania i naprawiania rzeczywistych błędów w dużych repozytoriach GitHub.
Ocena agentów i benchmarking SWE-bench
Metodologia i infrastruktura systematycznego pomiaru niezawodności, dokładności i bezpieczeństwa agentów AI przy użyciu testów syntetycznych, SWE-bench oraz symulacji repozytoriów w trybie headless.