Neuer Benchmark ohne transparente Details aufgetaucht
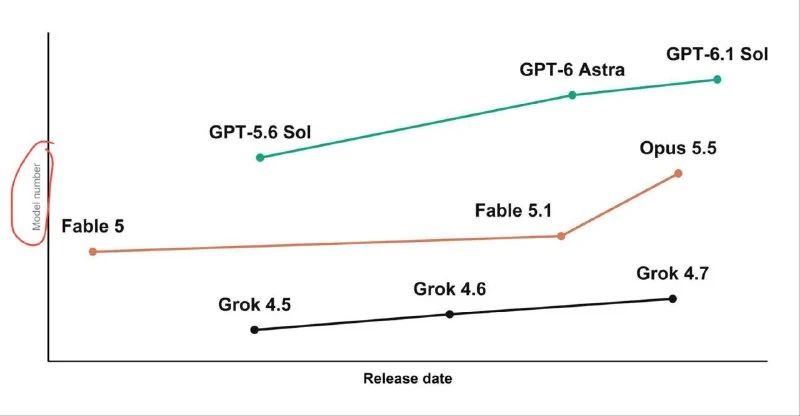
Ein neuer KI-Benchmark ist erschienen, jedoch ohne Offenlegung von Modellinformationen oder Metriken. Mangels technischer Dokumentation bleibt die Relevanz und Zuverlässigkeit der Bewertung derzeit unklar.
Ein neuer Benchmark hat in der KI-Community für Aufsehen gesorgt, allerdings fehlt es an jeglicher Transparenz regarding seiner Herkunft und Methodik.
Der ursprüngliche Beitrag enthält weder Links zu einem Code-Repository, noch Verweise auf wissenschaftliche Paper, spezifische Modelle oder definierte Evaluationsmetriken. Ohne diese grundlegenden Informationen ist es derzeit unmöglich, die Qualität des Tests oder die Validität der Ergebnisse zu überprüfen.
Warum das wichtig ist
AnalyseBenchmarks sind essenziell, um den Fortschritt im Bereich der künstlichen Intelligenz messbar zu machen. Doch ohne eine nachvollziehbare Quelle und klar definierte Metriken lässt sich die Aussagekraft eines solchen Tests nicht bewerten.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Modellvergleich 2026
Alle paar Wochen erscheint ein neues Modell, und jedes Mal stellen sich dieselben Fragen: Lohnt sich der Wechsel? Was hat sich geändert? Wofür lohnt sich die Investition?
GPT-6.2 Astra: Weitere 3D-Beispiele
GPT-6.2 Astra zeigt 3D-Szenen, darunter Nachbildungen von Vice City und Rick Astley, während komplexe Prompts die Nutzungslimits schnell verbrauchen können.
Agenten-Benchmarks: GAIA und SWE-bench
Eine neue Generation strenger praktischer Benchmarks zur Bewertung der Autonomie von Künstlicher Intelligenz. GAIA testet multimodale Aufgaben im offenen Web mit Dateien und Browser, während SWE-bench die Fähigkeit von Agenten überprüft, echte Bugs in großen GitHub-Repositories zu finden und zu beheben.
Agent Evals & SWE-bench Benchmarking
Methodik und Infrastruktur zur systematischen Messung der Zuverlässigkeit, Genauigkeit und Sicherheit von KI-Agenten mithilfe synthetischer Tests, SWE-bench und headless Repository-Simulationen.