DeepSeek lance un nouveau modèle multimodal dédié aux agents
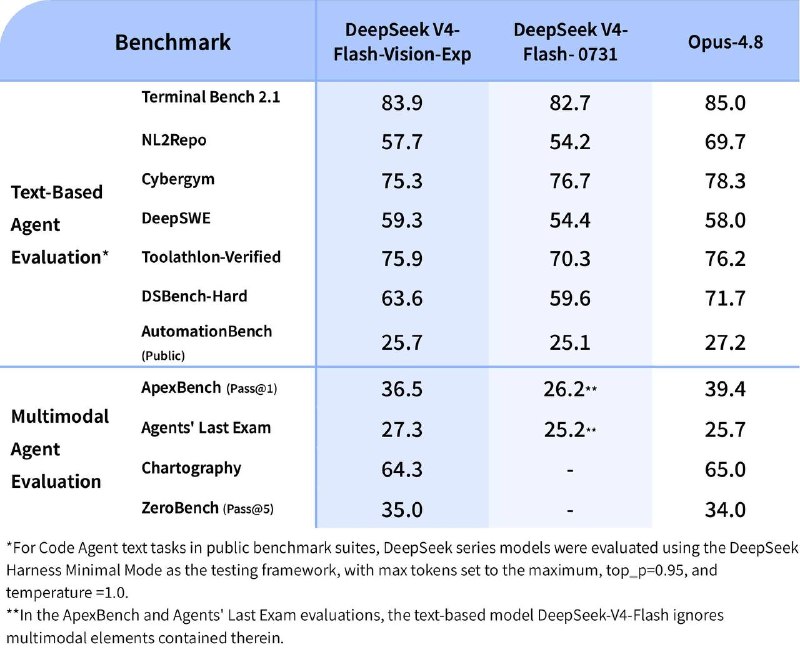
DeepSeek introduit DeepSeek-V4-Flash-Vision-Exp, un modèle multimodal haute performance pour les scénarios d'agents, accompagné d'une nouvelle version de DeepSeek Harness.
DeepSeek lance un nouveau modèle multimodal dédié aux agents
DeepSeek a dévoilé un nouveau modèle multimodal baptisé DeepSeek-V4-Flash-Vision-Exp. Il s'agit d'une extension de V4-Flash, spécifiquement conçue pour les scénarios d'agents multimodaux.
Malgré la mention « Flash » dans son nom, le modèle offre des performances comparables à celles d'Opus 4.8, voire supérieures dans certains cas. Parallèlement, ses capacités de traitement du texte restent équivalentes à celles de la version officielle DeepSeek-V4-Flash.
De plus, une nouvelle version, DeepSeek Harness 0.1.1, a été publiée, offrant un support prêt à l'emploi pour ce modèle.
La tarification de DeepSeek-V4-Flash est calculée jusqu'à 384 tokens par image, et le modèle prend en charge les formats JPEG, PNG, GIF et WebP.
Pourquoi c'est important
AnalyseCe nouveau modèle ouvre de nouvelles perspectives pour les applications agentiques, améliorant potentiellement l'efficacité du traitement des données multimodales tout en conservant des performances élevées sur les tâches textuelles.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
DeepSeek lance Creator Mode : le harness peut être remodelé par l’utilisateur
Le harness open source de DeepSeek ajoute Creator Mode : un agent écrit des plugins à partir de descriptions et les intègre directement dans l’interface.
Guide des prompts pour les modèles génératifs GPT Image
Les modèles de génération d'images gpt-image d'OpenAI sont conçus pour produire des visuels de qualité professionnelle et des processus créatifs entièrement maîtrisés. Ils conviennent aussi bien aux designers professionnels...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro : Comparaison des modèles 2026
Chaque semaine ou presque, un nouveau modèle est lancé, et les mêmes questions reviennent inlassablement : faut-il changer de solution ? Qu'est-ce qui a évolué ? Pour quoi payer ?
DeepSeek (La percée chinoise dans l'IA ouverte)
Série de modèles ouverts révolutionnaires issus du laboratoire chinois DeepSeek (V3, R1). Elle démontre un niveau d'excellence inégalé en codage et en raisonnement, à un coût 10 à 20 fois inférieur aux équivalents commerciaux occidentaux.