DeepSeek Lança Novo Modelo Multimodal para Agentes
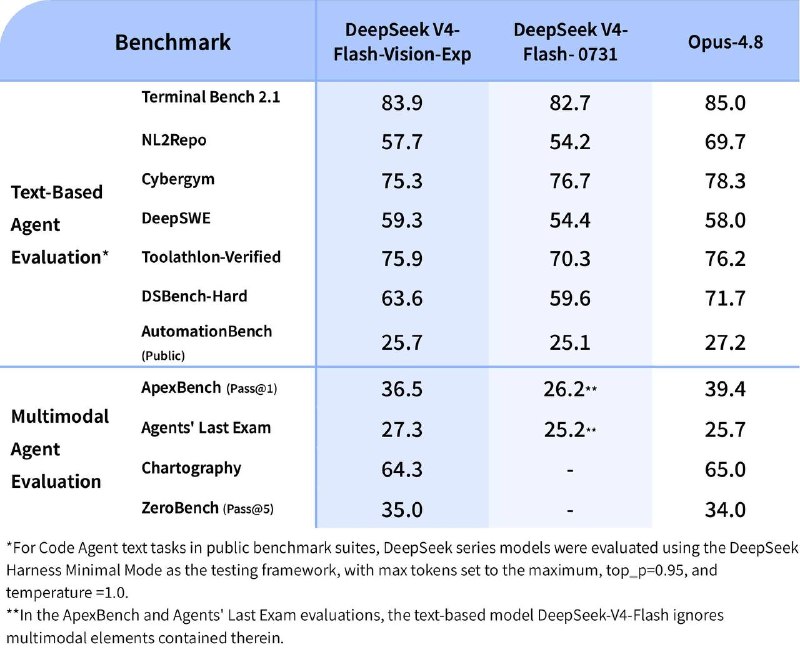
A DeepSeek apresentou o DeepSeek-V4-Flash-Vision-Exp, um modelo multimodal de alto desempenho para cenários de agentes, acompanhado pela atualização do DeepSeek Harness.
DeepSeek Lança Novo Modelo Multimodal para Agentes
A DeepSeek revelou um novo modelo multimodal denominado DeepSeek-V4-Flash-Vision-Exp. Este modelo é uma extensão do V4-Flash, projetado especificamente para cenários de agentes multimodais.
Apesar da designação "Flash" no seu nome, o modelo apresenta um nível de desempenho comparável ao Opus 4.8 e, em alguns casos, até superior. Ao mesmo tempo, as suas capacidades de processamento de texto mantêm-se alinhadas com as do DeepSeek-V4-Flash oficial.
Adicionalmente, foi lançada a nova versão DeepSeek Harness 0.1.1, que oferece suporte imediato (out-of-the-box) para este modelo.
O preço do DeepSeek-V4-Flash cobre até 384 tokens por imagem, e o modelo suporta os formatos JPEG, PNG, GIF e WebP.
Por que isso importa
AnáliseEste novo modelo da DeepSeek abre novas possibilidades para cenários de agentes, potencializando a eficiência no trabalho com dados multimodais. Além disso, mantém um elevado desempenho em tarefas de texto, tornando-se uma ferramenta versátil para desenvolvedores.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores