DeepSeek stellt neues multimodales Modell für Agenten vor
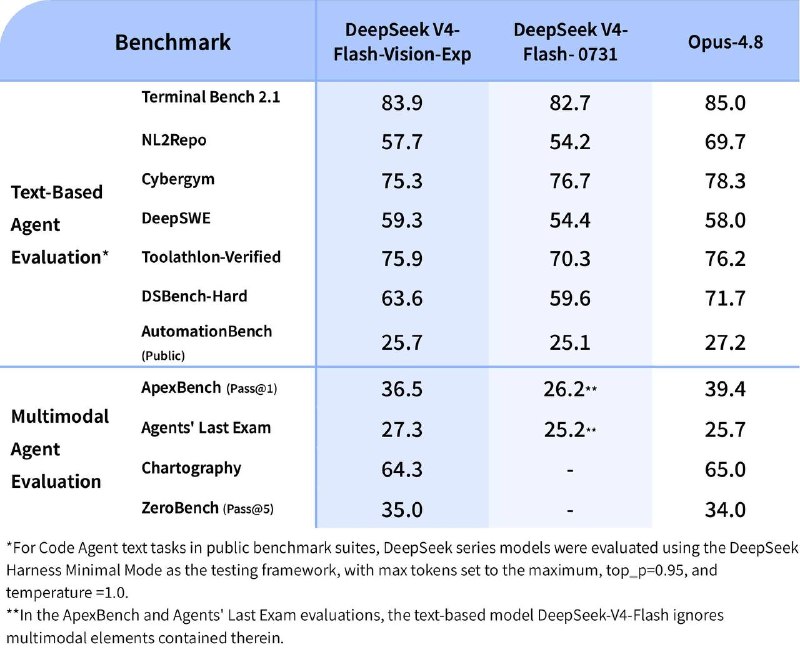
DeepSeek hat DeepSeek-V4-Flash-Vision-Exp lanciert, ein leistungsstarkes multimodales Modell für Agentenszenarien. Parallel dazu wurde DeepSeek Harness 0.1.1 veröffentlicht, das sofortige Unterstützung für das neue Modell bietet.
DeepSeek stellt neues multimodales Modell für Agenten vor
DeepSeek hat sein neues multimodales Modell DeepSeek-V4-Flash-Vision-Exp vorgestellt. Es handelt sich um eine Erweiterung von V4-Flash, die speziell für den Einsatz in multimodalen Agentenszenarien konzipiert wurde.
Trotz des Namenszusatzes „Flash“ erreicht das Modell Leistungswerte, die mit Opus 4.8 vergleichbar sind und diese in bestimmten Fällen sogar übertreffen. Gleichzeitig bleiben die Fähigkeiten zur Textverarbeitung auf dem Niveau des offiziellen DeepSeek-V4-Flash.
Zusätzlich wurde die neue Version DeepSeek Harness 0.1.1 veröffentlicht, die Out-of-the-Box-Support für das Modell bereitstellt.
Die Preisgestaltung für DeepSeek-V4-Flash basiert auf bis zu 384 Tokens pro Bild. Das Modell unterstützt die Formate JPEG, PNG, GIF und WebP.
Warum das wichtig ist
AnalyseDieses neue Modell eröffnet erweiterte Möglichkeiten für Agentenanwendungen und steigert potenziell die Effizienz bei der Verarbeitung multimodaler Daten. Durch die Beibehaltung hoher Leistungsstandards in Textaufgaben positioniert es sich als vielseitiges Werkzeug für Entwickler.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern