DeepSeek lanza un nuevo modelo multimodal para agentes
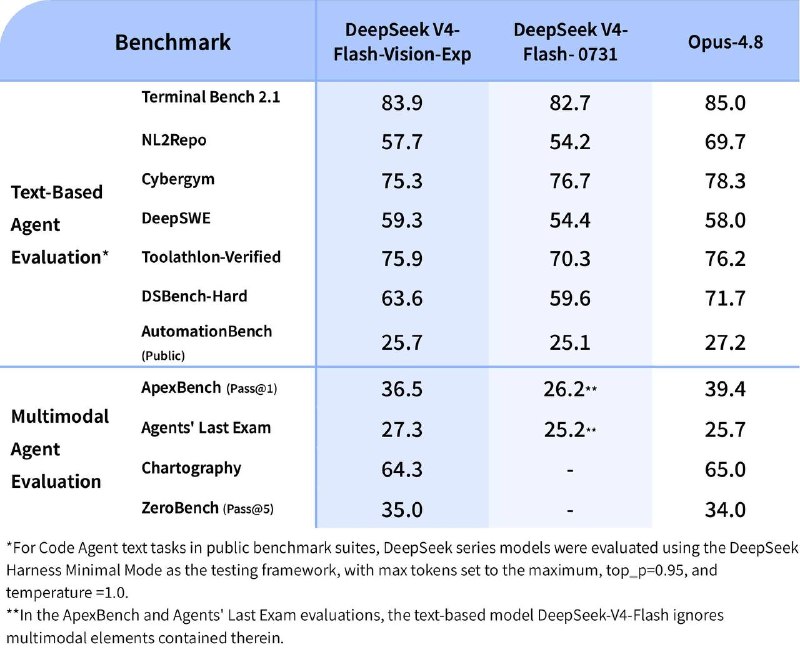
DeepSeek ha presentado un nuevo modelo multimodal, DeepSeek-V4-Flash-Vision-Exp, que muestra un alto rendimiento en escenarios de agentes. El modelo mantiene los niveles de productividad de versiones anteriores y también se ha lanzado una nueva versión de DeepSeek Harness.
DeepSeek lanza un nuevo modelo multimodal para agentes
DeepSeek ha revelado un nuevo modelo multimodal llamado DeepSeek-V4-Flash-Vision-Exp. Este modelo es una extensión de V4-Flash, diseñado específicamente para escenarios de agentes multimodales.
A pesar del "Flash" en su nombre, el modelo rinde a un nivel comparable al Opus 4.8, y en algunos casos, incluso mejor. Al mismo tiempo, sus capacidades de procesamiento de texto se mantienen al nivel del DeepSeek-V4-Flash oficial.
Además, se ha lanzado una nueva versión, DeepSeek Harness 0.1.1, que proporciona soporte inmediato para el modelo.
Los precios de DeepSeek-V4-Flash son de hasta 384 tokens por imagen, y admite formatos JPEG, PNG, GIF y WebP.
Por qué es importante
AnálisisEste nuevo modelo de DeepSeek abre nuevas posibilidades para escenarios de agentes, lo que puede mejorar la eficiencia en el trabajo con datos multimodales. También mantiene un alto rendimiento en tareas de texto, lo que lo convierte en una herramienta versátil para los desarrolladores.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Seis complementos para DeepSeek Harness que reducen el uso de tokens y ordenan el contexto
Revisión de seis complementos para DeepSeek Harness: acceso gratuito a modelos, gestión de memoria, enrutamiento de agentes y monitorización del contexto.
DeepSeek Harness presenta Creator Mode para crear plugins propios
DeepSeek Harness ha añadido un Creator Mode que permite crear plugins propios, espacios de trabajo, herramientas e interfaces. Los desarrolladores también publicaron los prompts en inglés y chino usados para crear los plugins de demostración.