Apple Silicon : l'architecture idéale pour les grands modèles de langage
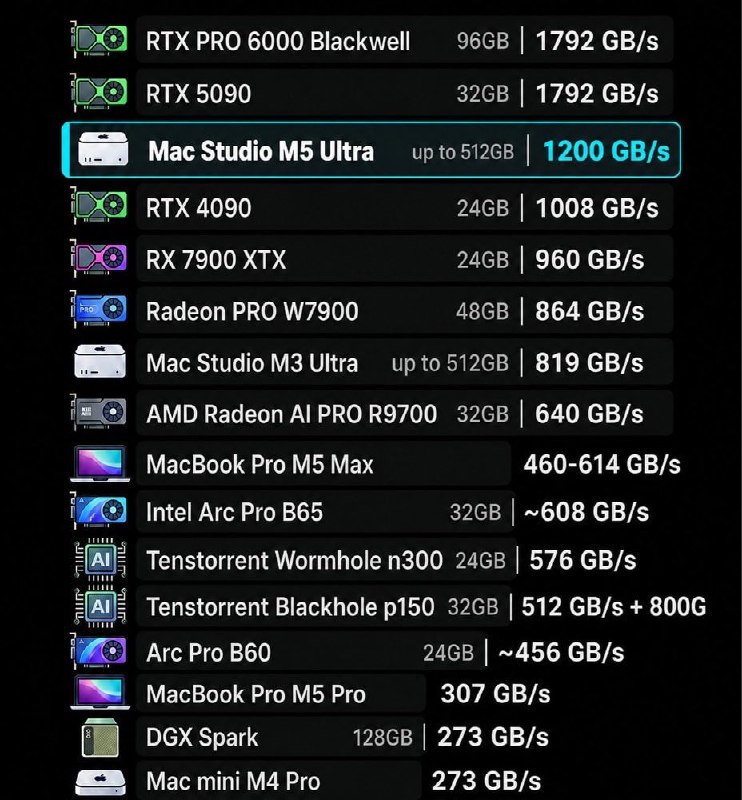
L'architecture Apple Silicon s'impose comme une solution optimale pour l'exécution locale des grands modèles de langage, grâce à sa mémoire unifiée et sa bande passante exceptionnelle.
Apple Silicon : l'architecture idéale pour les grands modèles de langage
L'architecture Apple Silicon s'est révélée presque parfaite pour l'exécution des grands modèles de langage (LLM). Cette performance repose sur une combinaison unique de mémoire rapide, d'une bande passante élevée et d'une architecture de mémoire unifiée.
Le Mac Studio M5 Ultra, équipé de 512 Go de mémoire et offrant une bande passante de 1,2 To/s, est capable d'accueillir entièrement le modèle GLM-5.3-Flash, qui compte 320 milliards de paramètres en précision FP8. Il délivre environ 60 tokens par seconde en local, directement depuis un poste de travail classique.
Une alternative sur PC ?
Il faudrait environ 10 cartes RTX 5090, pour un coût dépassant les 20 000 dollars, ainsi qu'une infrastructure électrique dédiée.
La version complète du GLM-5.3-Flash avec 320 milliards de paramètres en FP8 pèse environ 306 Go. Or, une seule RTX 5090 ne dispose que de 32 Go de mémoire vidéo. Par conséquent, il faut au moins 10 cartes graphiques rien que pour stocker les poids du modèle :
10 × 32 Go = 320 Go.
Le Mac Studio résout ce problème grâce à son pool de mémoire unifiée pouvant atteindre 512 Go, avec une bande passante de 1,2 To/s. Au lieu de construire un cluster PC multi-GPU, de gérer la latence du bus PCIe et une consommation électrique avoisinant les 5 000 W, il est possible de charger l'intégralité du modèle de 306 Go, ainsi qu'un contexte étendu et le cache KV, dans un seul ordinateur de bureau.
Pourquoi c'est important : Cette démonstration illustre comment les nouvelles architectures peuvent transformer les approches d'exécution des LLM, rendant leur déploiement plus accessible aux développeurs.
Pourquoi c'est important
AnalyseCette avancée démontre comment les innovations architecturales redéfinissent les standards d'exécution des LLM, rendant le déploiement local plus accessible et efficient pour les développeurs.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.
Format CSV : guide complet pour l'automatisation et le travail avec l'IA
Guide pratique sur l'utilisation du format CSV dans les pipelines d'IA : spécification RFC 4180, comparaison avec XLSX et JSON, nettoyage et enrichissement massif des données, codage en Python et prompts prêts à l'emploi.
Un utilisateur Reddit explique pourquoi les limites hebdomadaires de Claude Code se consomment presque 4 fois plus vite
Un utilisateur Reddit a comparé l’utilisation des tokens sur deux semaines et constaté que chaque 1 % de la limite hebdomadaire de Claude Code génère désormais beaucoup moins de tokens de sortie ; des sous-agents, la durée du raisonnement et les rafraîchissements de l’interface sont pointés comme causes possibles.
Des chercheurs du MIT montrent que GPT-6 Astra peut améliorer d’autres modèles d’IA en modifiant leurs poids
Dans une expérience, Astra a porté la précision de Qwen3.5-0.8B sur MATH-500 de 7,9 % à 48,1 % en ne modifiant que 0,016 % des poids du modèle.