Utiliser des sous-agents IA pour tester le parcours des premiers utilisateurs avant le lancement
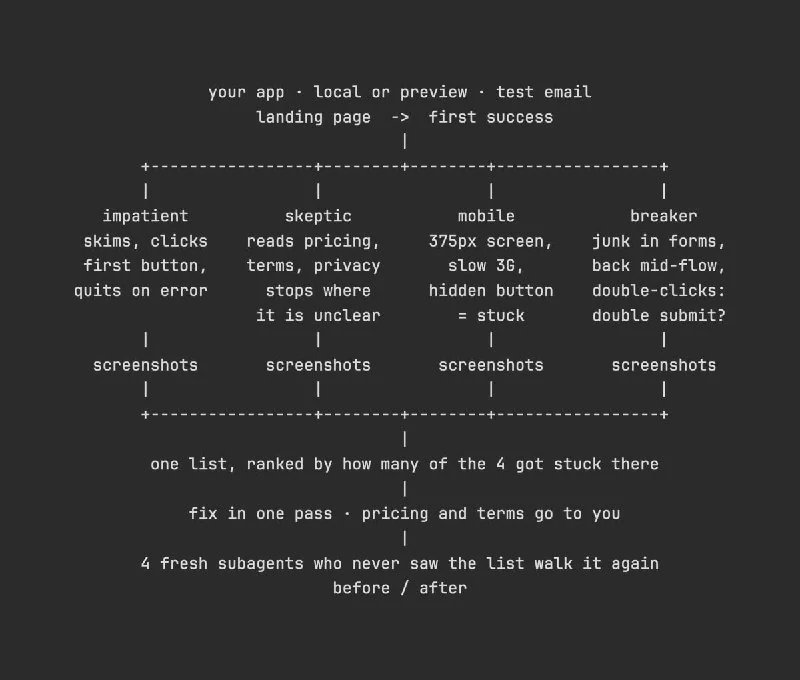
Un flux pré-lancement peut lancer quatre sous-agents IA qui imitent des utilisateurs impatients, sceptiques, mobiles et stress-testeurs, en consignant les points de friction avec des captures d'écran.
Conseil avant le lancement
Avant de lancer un produit, demandez à un agent IA de lancer quatre sous-agents qui imitent de nouveaux utilisateurs afin de tester tout le parcours depuis l'ouverture de la page d'accueil jusqu'à la première action réussie.
À chaque fois que l'un d'eux ne comprend pas quoi faire ensuite, reste bloqué ou veut fermer l'onglet, le problème est ajouté à un tableau commun avec une capture d'écran.
- Utilisateur impatient : parcourt la page rapidement, clique sur le premier bouton disponible et ferme l'onglet dès la première erreur.
- Sceptique : examine les tarifs, les conditions d'utilisation et la politique de confidentialité avant de s'inscrire. S'arrête sur tout ce qui semble peu clair.
- Utilisateur mobile : écran de 375 pixels de large et connexion 3G lente. Un bouton caché ou un défilement horizontal est considéré comme un problème.
- Testeur de robustesse : saisit des données invalides dans tous les formulaires, revient en arrière à mi-parcours et double-clique sur les boutons pour vérifier si une action est exécutée deux fois.
Les problèmes du tableau sont triés selon le nombre d'agents qui les ont rencontrés. Corrigez tout ce qui peut être résolu en une seule passe, puis lancez quatre nouveaux sous-agents qui n'ont pas vu le tableau des problèmes afin qu'ils refassent le même parcours et vérifient si des obstacles restent.
Pour obtenir un tel tableau avant le lancement, envoyez à l'agent le prompt suivant :
Mon produit va bientôt être lancé. Aide-moi à trouver les endroits où les premiers utilisateurs pourraient rencontrer des difficultés.
Vérifie d'abord si tu as accès à un MCP de navigateur. Sinon, arrête-toi et donne-moi la commande pour installer
Playwright MCP.Étudie le code, détermine quelle action est considérée comme le premier résultat réussi pour l'utilisateur et indique-le au début du rapport.
Lance ensuite quatre sous-agents, chacun imitant un nouvel utilisateur. Ils doivent utiliser le navigateur séquentiellement : le suivant ne commence qu'après la fin du précédent.
Chaque sous-agent doit parcourir le chemin de la page d'accueil jusqu'au premier résultat réussi.
Prends des captures d'écran de tous les endroits où les sous-agents rencontrent des difficultés, restent bloqués ou veulent fermer l'onglet. Sauvegarde-les dans
qa/first-users/et consigne l'étape, ce qui a été vu et l'action que l'utilisateur tentait d'effectuer.À la fin, chaque sous-agent doit indiquer s'il retournerait vers le produit et combien de clics ont été nécessaires pour atteindre le premier résultat réussi.
Travaille uniquement dans un environnement local ou un environnement de prévisualisation. Utilise une adresse e-mail de test pour l'inscription et le mode test pour les paiements.
Considère comme un seul problème les incidents identiques qui surviennent au même endroit sur la même page. Trie-les selon le nombre d'utilisateurs qui les ont rencontrés.
Consigne simplement pour moi les problèmes liés aux tarifs, aux conditions d'utilisation et à la politique de confidentialité.
Corrige tous les autres problèmes en une seule passe.
Lance ensuite quatre nouveaux sous-agents qui n'ont pas vu la liste des problèmes découverts. Demande-leur de répéter le test dans les mêmes conditions.
À la fin, fournis une comparaison des résultats avant et après les corrections.
Pourquoi c'est important
AnalyseCette approche aide à repérer les pièges d'UX avant la mise en production publique et réduit l'abandon des premiers utilisateurs. Elle transforme aussi les tests en un processus répétable avec des résultats mesurables avant et après correction.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Loop Engineering : architecture des boucles autonomes et fin de l'ère du prompting manuel
Plongée approfondie dans le Loop Engineering : architecture de cycles auto-entretenus pour Claude Code et les agents autonomes, modèle DOER/CHECKER, vérification déterministe, commande /goal et lutte contre le Reward Hacking.
Appels de fonctions (Function Calling / Tool Calling)
Protocole technique et standard d'interaction entre les LLM et les logiciels externes. Au lieu de générer du texte libre, le modèle retourne un JSON valide contenant le nom de la fonction et des arguments typés selon un schéma JSON Schema, permettant au backend d'exécuter des actions déterministes sur des API réelles.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.
Mémoire à court et long terme des agents
Architecture de mémoire hiérarchique pour les agents autonomes. Distinction entre la mémoire à court terme (Short-Term Memory — fenêtre contextuelle active de la session en cours) et la mémoire à long terme (Long-Term Memory — bases de données vectorielles, fichiers de profil utilisateur et journaux épisodiques).
shot : un mod MCP pour Claude Code qui affiche les étapes de l'agent IA à l'écran
Le nouveau mod MCP shot ajoute des outils de capture d'écran à Claude Code, permettant à un agent IA de montrer chaque action dans une application étape par étape.
Anthropic lance l’aperçu de Duet, un concurrent de dots
Anthropic a ouvert un aperçu de Duet, une application distincte pour interagir avec un agent cloud proactif et toujours actif ; l’accès est promis aux abonnés à 20 $, mais pour l’instant seulement aux États-Unis.