Mit KI-Subagenten die erste Nutzerreise vor dem Produktstart testen
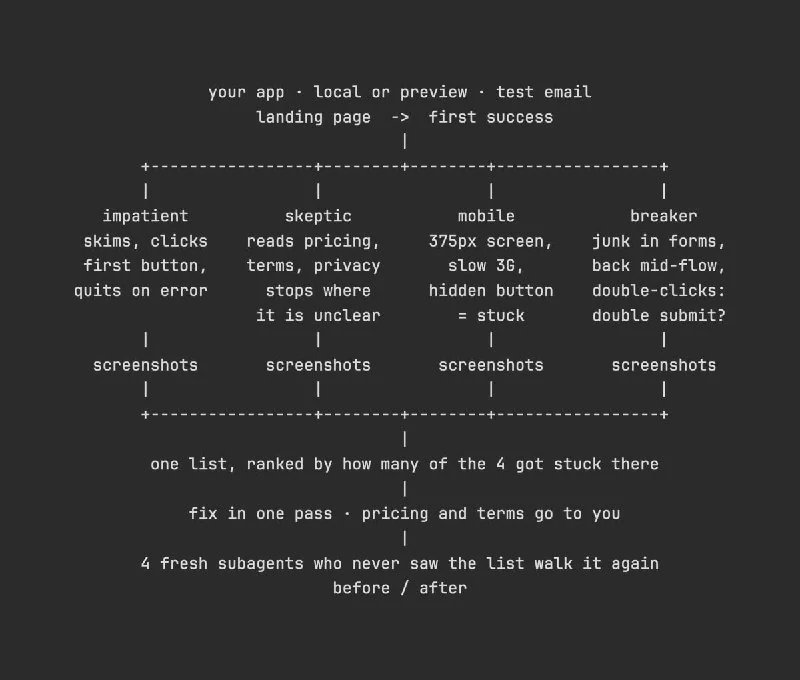
Ein Workflow vor dem Launch kann vier KI-Subagenten starten, die ungeduldige, skeptische, mobile und Stress-Test-Nutzer imitieren und Reibungspunkte mit Screenshots erfassen.
Tipp vor dem Launch
Bitten Sie vor dem Start eines Produkts einen KI-Agenten, vier Subagenten zu starten, die neue Nutzer imitieren, um den gesamten Weg vom Öffnen der Startseite bis zur ersten erfolgreichen Aktion zu prüfen.
Immer wenn einer von ihnen nicht weiß, was als Nächstes zu tun ist, hängenbleibt oder den Tab schließen möchte, wird das Problem in einer gemeinsamen Tabelle mit Screenshot erfasst.
- Ungeduldiger Nutzer: überfliegt die Seite, klickt auf den ersten verfügbaren Button und schließt den Tab nach dem ersten Fehler.
- Skeptiker: prüft Preise, Nutzungsbedingungen und Datenschutzrichtlinie vor der Registrierung. Bleibt bei allem stehen, was unklar wirkt.
- Mobilnutzer: Bildschirm mit 375 Pixeln Breite und langsame 3G-Verbindung. Ein versteckter Button oder horizontales Scrollen gilt als Problem.
- Stresstester: gibt in allen Formularen ungültige Daten ein, geht mitten im Prozess zurück und klickt Buttons doppelt, um zu prüfen, ob eine Aktion mehrfach ausgeführt wird.
Probleme in der Tabelle werden nach der Anzahl der Agenten sortiert, die auf sie gestoßen sind. Beheben Sie alles, was in einem Durchgang korrigiert werden kann, und starten Sie danach vier neue Subagenten, die die Problemtabelle nicht gesehen haben, damit sie denselben Weg erneut durchlaufen und prüfen, ob Hindernisse bleiben.
Um eine solche Tabelle vor dem Launch zu erhalten, senden Sie dem Agenten diesen Prompt:
Mein Produkt startet bald. Hilf mir, Stellen zu finden, an denen erste Nutzer Schwierigkeiten haben könnten.
Prüfe zuerst, ob dir ein Browser-MCP zur Verfügung steht. Wenn nicht, stoppe und gib mir den Befehl zur Installation von
Playwright MCP.Untersuche den Code, bestimme, welche Aktion als erstes erfolgreiches Ergebnis für Nutzer gilt, und nenne sie am Anfang des Berichts.
Starte danach vier Subagenten, von denen jeder einen neuen Nutzer imitiert. Sie müssen den Browser nacheinander verwenden: Der nächste beginnt erst, wenn der vorherige abgeschlossen hat.
Jeder Subagent muss den Weg von der Startseite bis zum ersten erfolgreichen Ergebnis durchlaufen.
Erstelle Screenshots aller Stellen, an denen Subagenten Schwierigkeiten haben, hängenbleiben oder den Tab schließen möchten. Speichere sie in
qa/first-users/und erfasse die Stufe, das Gesehene und die Aktion, die der Nutzer ausführen wollte.Am Ende soll jeder Subagent berichten, ob er zum Produkt zurückkehren würde und wie viele Klicks für das erste erfolgreiche Ergebnis nötig waren.
Arbeite nur in einer lokalen Umgebung oder einer Vorschau-Umgebung. Verwende für die Registrierung eine Test-E-Mail-Adresse und für Zahlungen den Testmodus.
Behandle identische Probleme, die an derselben Stelle auf derselben Seite auftreten, als ein Problem. Sortiere sie nach der Anzahl der Nutzer, die ihnen begegnet sind.
Probleme mit Preisen, Nutzungsbedingungen und Datenschutzrichtlinie einfach für mich protokollieren.
Alle anderen Probleme in einem Durchgang beheben.
Starte danach vier neue Subagenten, die die Liste der entdeckten Probleme nicht gesehen haben. Lass sie den Test unter denselben Bedingungen wiederholen.
Gib am Ende einen Vergleich der Ergebnisse vor und nach den Korrekturen.
Warum das wichtig ist
AnalyseDieser Ansatz hilft, UX-Fallen vor dem öffentlichen Release zu finden und die Abwanderung erster Nutzer zu reduzieren. Er macht Tests zudem zu einem wiederholbaren Prozess mit messbaren Vorher-nachher-Ergebnissen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Loop Engineering: Architektur autonomer Schleifen und das Ende des manuellen Promptings
Ein tiefgehender Einblick in Loop Engineering: Architektur selbstunterhaltender Zyklen für Claude Code und autonome Agenten, DOER/CHECKER-Muster, deterministische Verifizierung, der /goal-Befehl und die Bekämpfung von Reward Hacking.
Funktionsaufruf (Function Calling / Tool Calling)
Technisches Protokoll und Standard für die Interaktion von LLMs mit externer Software. Anstelle von Freitext gibt das Modell ein valides JSON-Objekt zurück, das den Funktionsnamen und typisierte Argumente gemäß dem JSON-Schema enthält. Dies ermöglicht es dem Backend, Aktionen in echten APIs deterministisch auszuführen.
Erstellung von Skills für Claude Code: Von der Architektur bis zum Testen
Umfassendes technisches Handbuch zur Erstellung von Skills für Claude Code: Ordnerstruktur und SKILL.md, schrittweise Offenlegung (Progressive Disclosure), Unterschiede zu Hooks sowie ein Evaluation-getriebener Ansatz.
Agent-to-Agent Protocol (A2A)
Ein offener Standard für Netzwerkinteraktion, dezentrale Entdeckung und sicheren Kontextaustausch zwischen unabhängigen KI-Agenten verschiedener Anbieter und Plattformen.
Anthropic startet Duet-Vorschau — ein Konkurrent von dots
Anthropic hat eine Vorschau von Duet eröffnet, einer separaten App für die Interaktion mit einem proaktiven Always-on-Cloud-KI-Agenten; Zugang soll es auch für 20-$-Abonnenten geben, vorerst nur in den USA.
shot: Ein MCP-Mod für Claude Code, der KI-Agentenschritte auf dem Bildschirm zeigt
Der neue MCP-Mod shot ergänzt Claude Code um Screenshot-Funktionen, sodass ein KI-Agent App-Aktionen Schritt für Schritt auf dem Bildschirm zeigen kann.