Meta présente la nouvelle série de modèles Muse Wonder
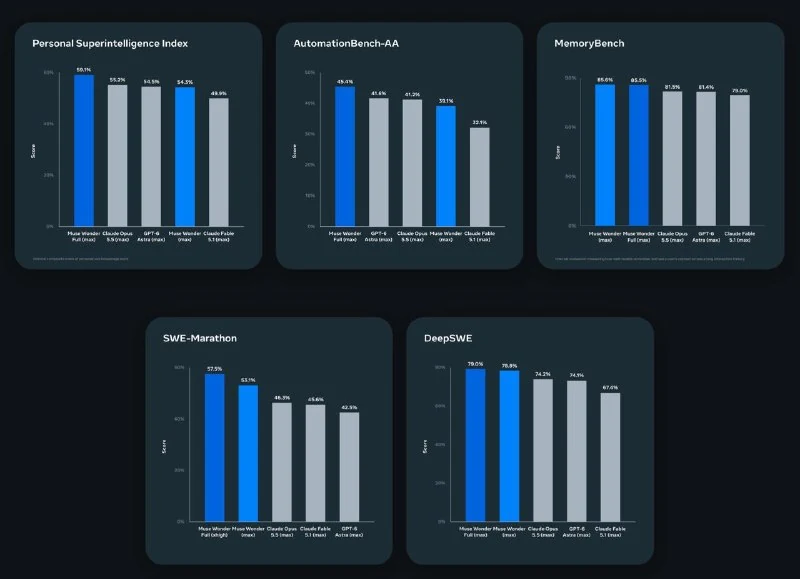
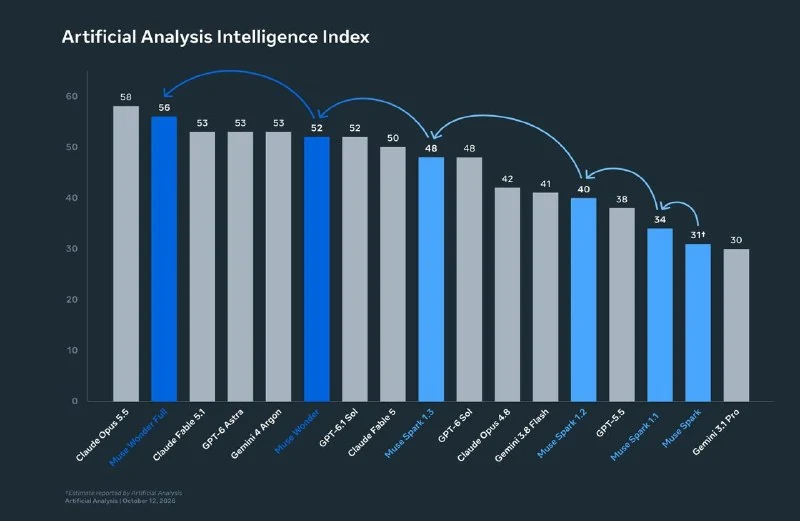
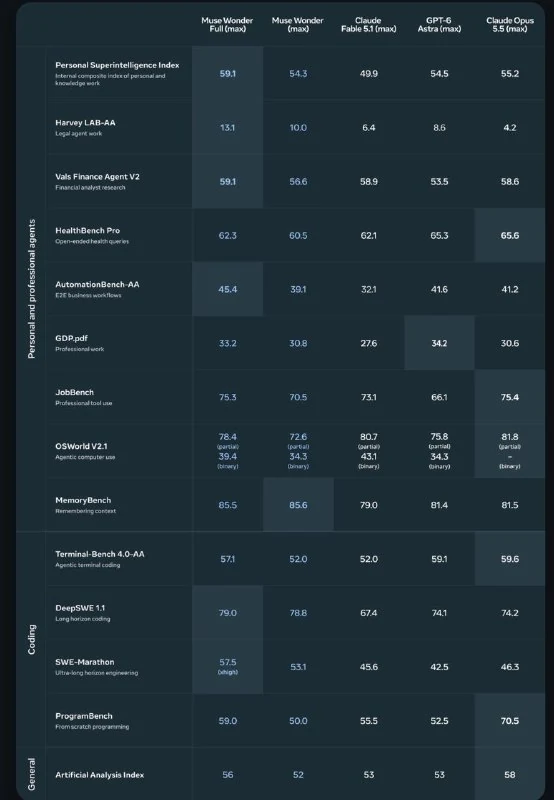
Meta a présenté Muse Wonder et Muse Wonder Full, de nouveaux modèles d’IA pour les tâches longues, le codage et les agents, avec Active Memory pour récupérer le contexte pertinent.
Meta a présenté la série de modèles Muse Wonder, composée de Muse Wonder et Muse Wonder Full. L’entreprise les décrit comme une nouvelle étape sur l’échelle du scaling vers la superintelligence personnelle.
Sur le benchmark DeepSWE, le modèle a dépassé de manière inattendue Opus 5.5 et GPT-6 Astra, tandis que sur Terminal Bench il surpasse Fable 5.1. Selon les développeurs, les nouveaux modèles ont été entraînés pour les tâches longues, le codage et les workflows d’agents. Par rapport à Muse Spark 1.3, ils utilisent un modèle de base plus grand, ce qui, selon eux, produit une généralisation beaucoup plus puissante sur des tâches inconnues après le post-training.
Meta a également ajouté Active Memory : les modèles peuvent récupérer en temps réel le contexte pertinent issu d’autres conversations pour une tâche précise.
Les modèles sont déjà disponibles via la Meta Model API et dans Muse Code.
Pourquoi c'est important
AnalyseC’est important car Meta positionne Muse Wonder comme une étape vers la superintelligence personnelle et revendique de bons résultats dans les benchmarks de codage et les workflows d’agents.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs