Meta przedstawia nową serię modeli Muse Wonder
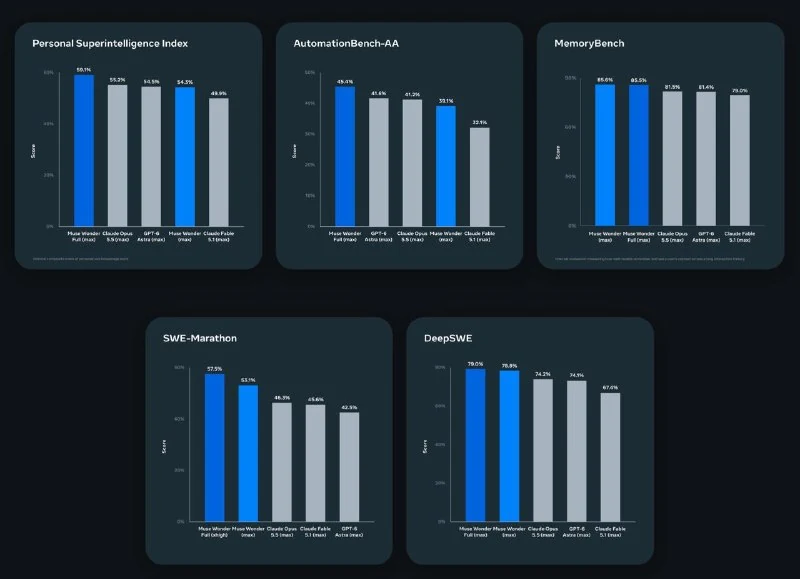
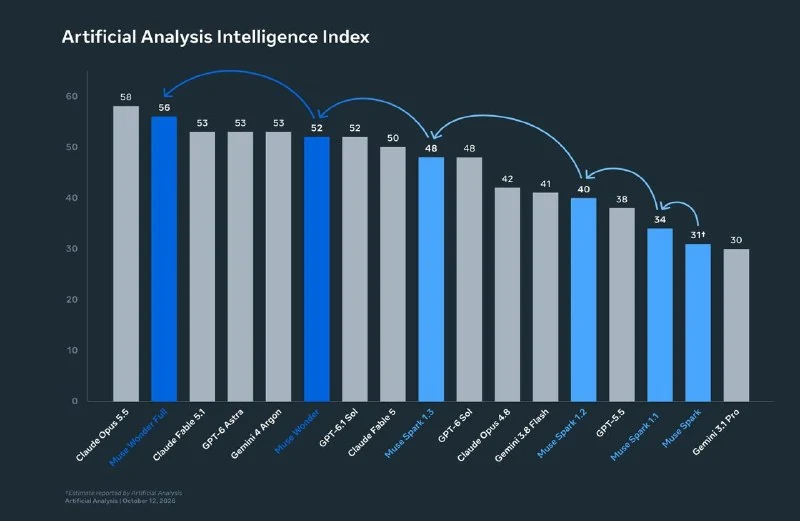
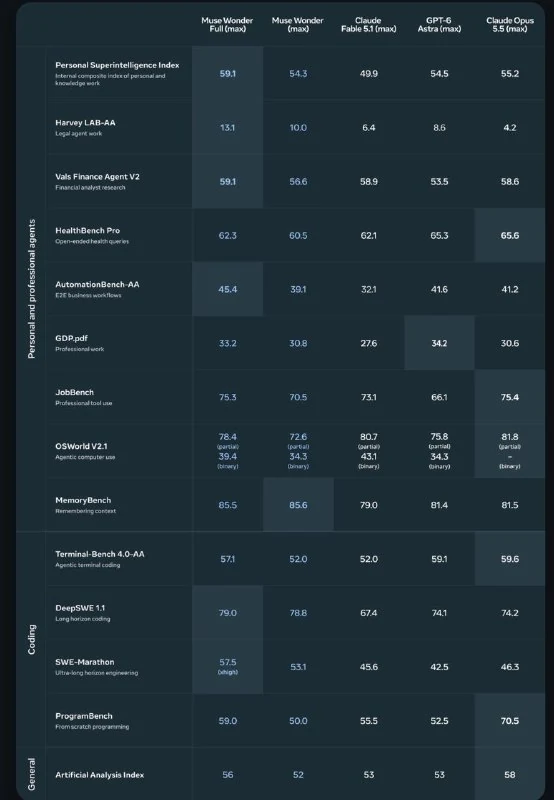
Meta zaprezentowała Muse Wonder i Muse Wonder Full — nowe modele AI do długich zadań, kodowania i agentów, z funkcją Active Memory do dynamicznego kontekstu.
Meta przedstawiła serię modeli Muse Wonder, obejmującą Muse Wonder i Muse Wonder Full. Firma opisuje je jako kolejny krok na drabinie skalowania ku osobistej superinteligencji.
W teście DeepSWE model niespodziewanie wyprzedził Opus 5.5 i GPT-6 Astra, a w Terminal Bench pokonał Fable 5.1. Według deweloperów nowe modele były trenowane do długich zadań, kodowania i przepływów agentowych. W porównaniu z Muse Spark 1.3 zastosowano większy model bazowy, co — jak twierdzą — zapewnia znacznie silniejszą generalizację na nieznanych zadaniach po post-treningu.
Dodano też funkcję Active Memory: modele mogą w czasie rzeczywistym pobierać odpowiedni kontekst z innych rozmów do konkretnego zadania.
Modele są już dostępne przez Meta Model API oraz w Muse Code.
Dlaczego to ważne
AnalizaTo ważne, ponieważ Meta pozycjonuje Muse Wonder jako krok w stronę osobistej superinteligencji i deklaruje silne wyniki w benchmarkach kodowania oraz przepływach agentowych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami