Meta presenta la serie de modelos Muse Wonder
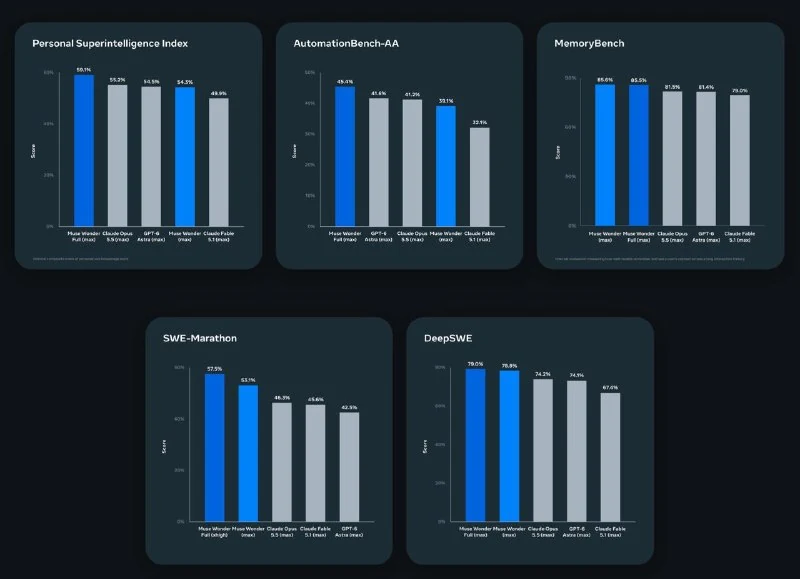
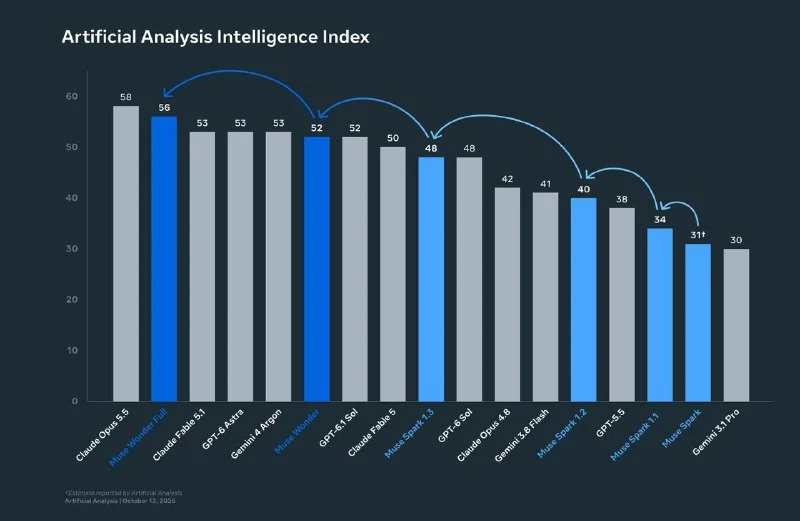
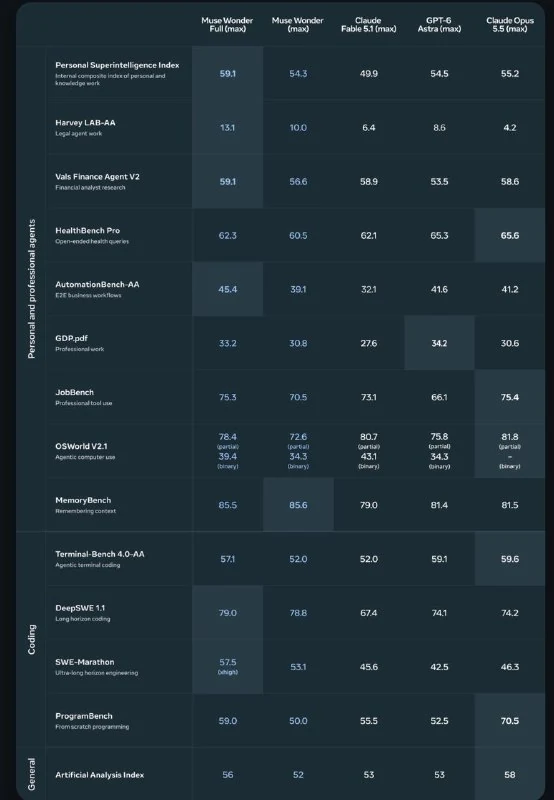
Meta lanzó Muse Wonder y Muse Wonder Full para tareas largas, programación y agentes, con Active Memory para recuperar contexto en línea.
Meta presentó la nueva serie de modelos Muse Wonder. La línea incluye dos modelos: Muse Wonder y Muse Wonder Full. La compañía los describe como otro paso en la escalera de escalado hacia la superinteligencia personal.
Según los primeros resultados, el modelo supera a Opus 5.5 y GPT-6 Astra en DeepSWE, y a Fable 5.1 en Terminal Bench.
Los modelos están entrenados para tareas largas, programación y agentes. En comparación con Muse Spark 1.3, utilizan una nueva base de mayor tamaño; los desarrolladores afirman que esto produjo una generalización mucho más fuerte hacia tareas desconocidas tras el post-entrenamiento.
También se añadió Active Memory: ahora los modelos pueden recuperar contexto relevante de otras conversaciones en línea para una tarea concreta.
Los modelos ya están disponibles mediante Meta Model API y en Muse Code. Más detalles en el anuncio oficial.
Por qué es importante
AnálisisLos resultados en benchmarks de programación y la función Active Memory pueden mejorar el rendimiento de agentes autónomos en flujos de trabajo complejos.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores