Próba wygenerowania złożonego, kinematograficznego wideo za pomocą jednego promptu tekstowego w modelu AI często prowadzi do rozmytych wyników: rysy twarzy zmieniają się między klatkami, ubrania „mutują”, a ruch kamery okazuje się nieprzewidywalny.
Rozwiązaniem tego problemu jest hybrydowy pipeline z jasnym podziałem ról: GPT Image 2 odpowiada za art direction, design postaci oraz wieloklatkowe storyboardy, natomiast Seedance 2.0 przejmuje fizykę ruchu, dynamikę kamery i finalny rendering wideo.
1. Przegląd i kluczowe zalety połączenia modeli
Połączenie dwóch wyspecjalizowanych narzędzi pozwala wyeliminować losowość z generatywnego procesu tworzenia wideo.
1.1. Koncepcja podziału odpowiedzialności: preprodukcja vs animacja
- GPT Image 2 (
gpt-image-2) pełni rolę działu concept artu i storyboarding: tworzy arkusze modelowe postaci, palety kolorów, siatki scen oraz bogate informacyjnie kompozycje z czytelnym tekstem. - Seedance 2.0 działa jako cyfrowy operator i animator: przekształca statyczne dane wizualne w płynne klipy o długości 4–15 sekund, z kontrolowaną prędkością ruchu i oprawą audio-wizualną.
Połączenie modeli zawsze wykazuje wyższą stabilność niż bezpośrednia generacja text-to-video. Model wideo skupia się wyłącznie na kinetyce i fizyce światła, nie zużywając zasobów obliczeniowych na jednoczesne projektowanie anatomii bohaterów i geometrii przestrzeni.
1.2. Bazowy pipeline od pomysłu do gotowego wideo
Standardowy proces produkcyjny przebiega według prostej ścieżki: formułowanie koncepcji ujęć → tworzenie kotwic wizualnych → składanie storyboardu lub klatek kluczowych → animacja w Seedance 2.0 → finalny montaż i nałożenie dźwięku.
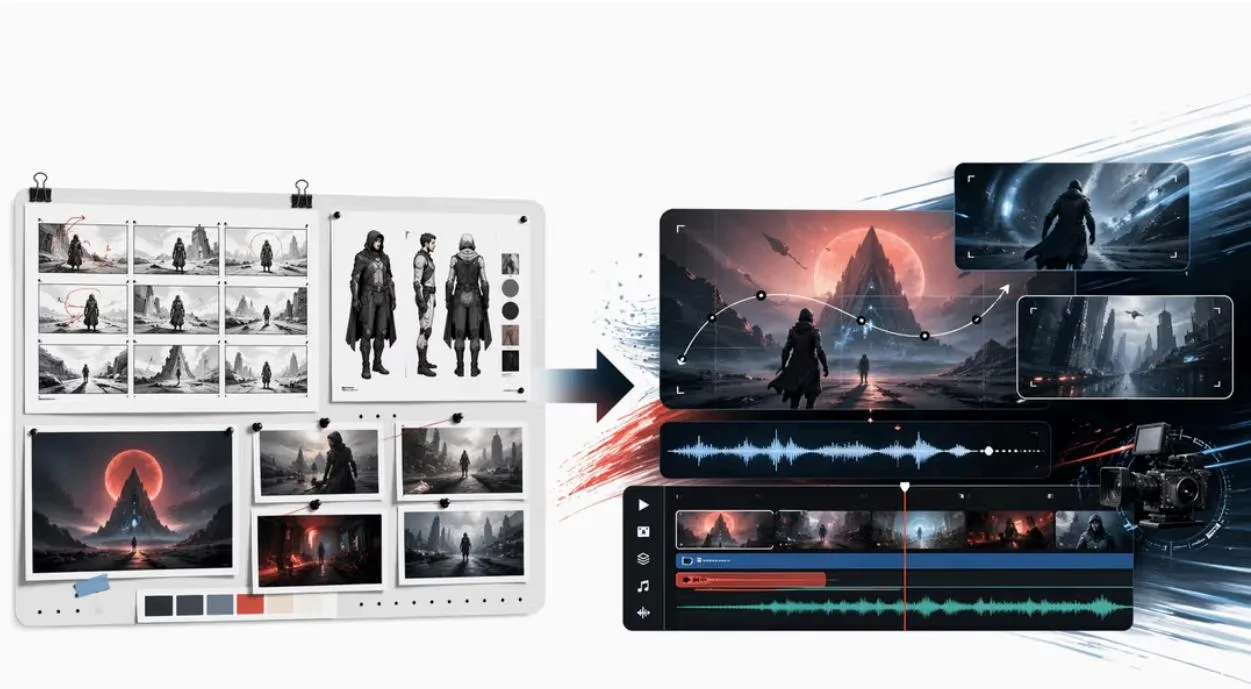 Ogólna schemat pipeline od storyboarding do timeline wideo — ilustracja 1
Takie podejście jest niezastąpione przy produkcji trailerów, teaserów reklamowych, prezentacji produktowych oraz stylizowanych klipów do mediów społecznościowych.
2. Co każdy model robi najlepiej
Najefektywniej dzielić zadania między modele zgodnie ze stadiami produkcji filmowej, a nie marketingowymi hasłami.
2.1. Mocne strony i specjalizacja GPT Image 2
Model GPT Image 2 jest zoptymalizowany pod kątem preprodukcji: generowania wysoko szczegółowych scen statycznych, renderowania czytelnych napisów na szyldach i planszach tytułowych, a także budowania wieloklatkowych siatek komiksów i storyboardów. Jego główna wartość to przewidywalność i utrwalenie stylu wizualnego.
2.2. Możliwości i fokus Seedance 2.0
Seedance 2.0 (opracowany przez BytePlus) wspiera multimodalne generowanie wideo na podstawie obrazów referencyjnych, dźwięku i tekstu. Jego mocną stroną jest oddanie inercji ruchu, konfiguracja trajektorii kamery (panorama, najazd, śledzenie) oraz stabilność przemieszczania obiektów w przestrzeni.
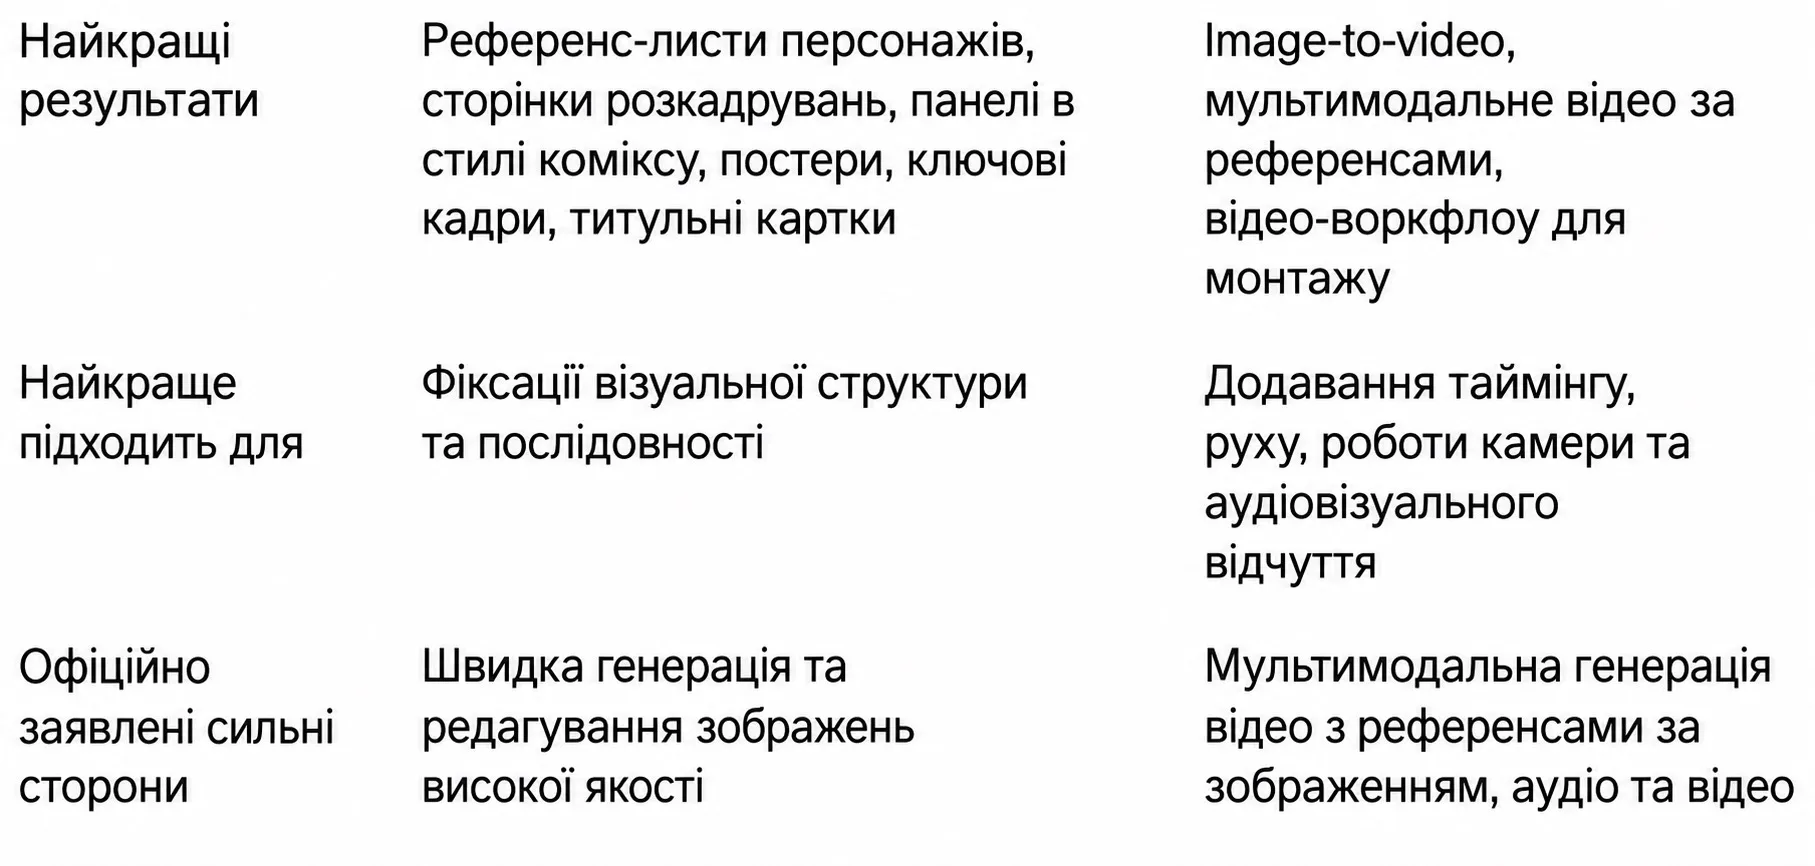 Tabela porównawcza specjalizacji modeli — ilustracja 2
| Kryterium oceny | GPT Image 2 (gpt-image-2) | Seedance 2.0 |
|---|---|---|
| Etap produkcji | Wizualna preprodukcja i art direction | Animacja, symulacja ruchu i rendering wideo |
| Modalności wejściowe | Opis tekstowy + obrazy referencyjne | Tekst, obrazy referencyjne, audio i wideo |
| Kluczowe artefakty | Arkusze referencyjne, storyboardy, plakaty, plansze tytułowe | Gotowe klipy (4–15 s), animacja image-to-video |
| Główna specjalizacja | Utrwalenie struktury wizualnej, tekstu i stylu | Timing, trajektoria kamery i fizyka ruchu |
| Oficjalne atuty | Szybka generacja i edycja złożonych obrazów | Multimodalna synteza wideo na podstawie referencji |
3. Dlaczego połączenie działa lepiej niż jeden uniwersalny model
Podział zadań między modele rozwiązuje trzy główne problemy generatywnego wideo.
3.1. Wczesne utrwalenie spójności wizualnej postaci
Bezpośredni generator wideo musi w jednym przebiegu obliczać anatomię, materiały kostiumu, oświetlenie i trajektorię biegu. Gdy zespół utrwali arkusz modelowy bohatera w GPT Image 2, Seedance otrzymuje sztywną kotwicę wizualną, co eliminuje przypadkowe mutacje i dryf rysów twarzy między klatkami.
3.2. Uproszczenie kontroli nad tempem i bitami montażowymi
Stworzenie siatki storyboardu 3×3 lub sekwencji klatek kluczowych pozwala reżyserowi zatwierdzić rytm narracji przed uruchomieniem kosztownej generacji wideo:
- Utrwalić listę wymaganych planów (ogólny, średni, detal).
- Ocenić kompozycję wizualną każdej klatki w wersji statycznej.
- Przekazać klatki do modelu wideo w celu dodania ruchu.
3.3. Zachowanie złożonej typografii i layoutów
GPT Image 2 świetnie radzi sobie z tekstem drukowanym, logotypami na ubraniach i grafikami naklejek. Generowanie tych elementów bezpośrednio w modelach wideo niemal zawsze powoduje artefakty „rozmycia” liter. Przygotowanie statycznych plansz tytułowych całkowicie eliminuje ten problem.
4. Standardowe workflow: Storyboard-first vs Keyframe-first
W zależności od celów projektu pipeline produkcyjny dzieli się na dwa podstawowe wzorce.
4.1. Wzorzec Storyboard-first: dla dynamicznych trailerów i narracji
W podejściu Storyboard-first GPT Image 2 generuje pojedynczą wieloklatkową stronę (siatkę 3×3 lub poziomą taśmę 16:9), gdzie wszystkie epizody są ułożone chronologicznie. Ten arkusz jest ładowany do Seedance 2.0 jako pojedynczy multimodalny referens, dzięki czemu model wideo utrzymuje ciągły ruch kamery przez całą scenę.
4.2. Wzorzec Keyframe-first: dla szczegółowej kontroli klatkowej
W podejściu Keyframe-first każda klatka przyszłego klipu jest tworzona jako osobny, wysokiej jakości obraz z precyzyjną konfiguracją oświetlenia i pozy. Następnie każda klatka jest animowana w Seedance 2.0 jako niezależny fragment 3–5 sekundowy, a finalne cięcie wykonuje się w edytorze wideo.
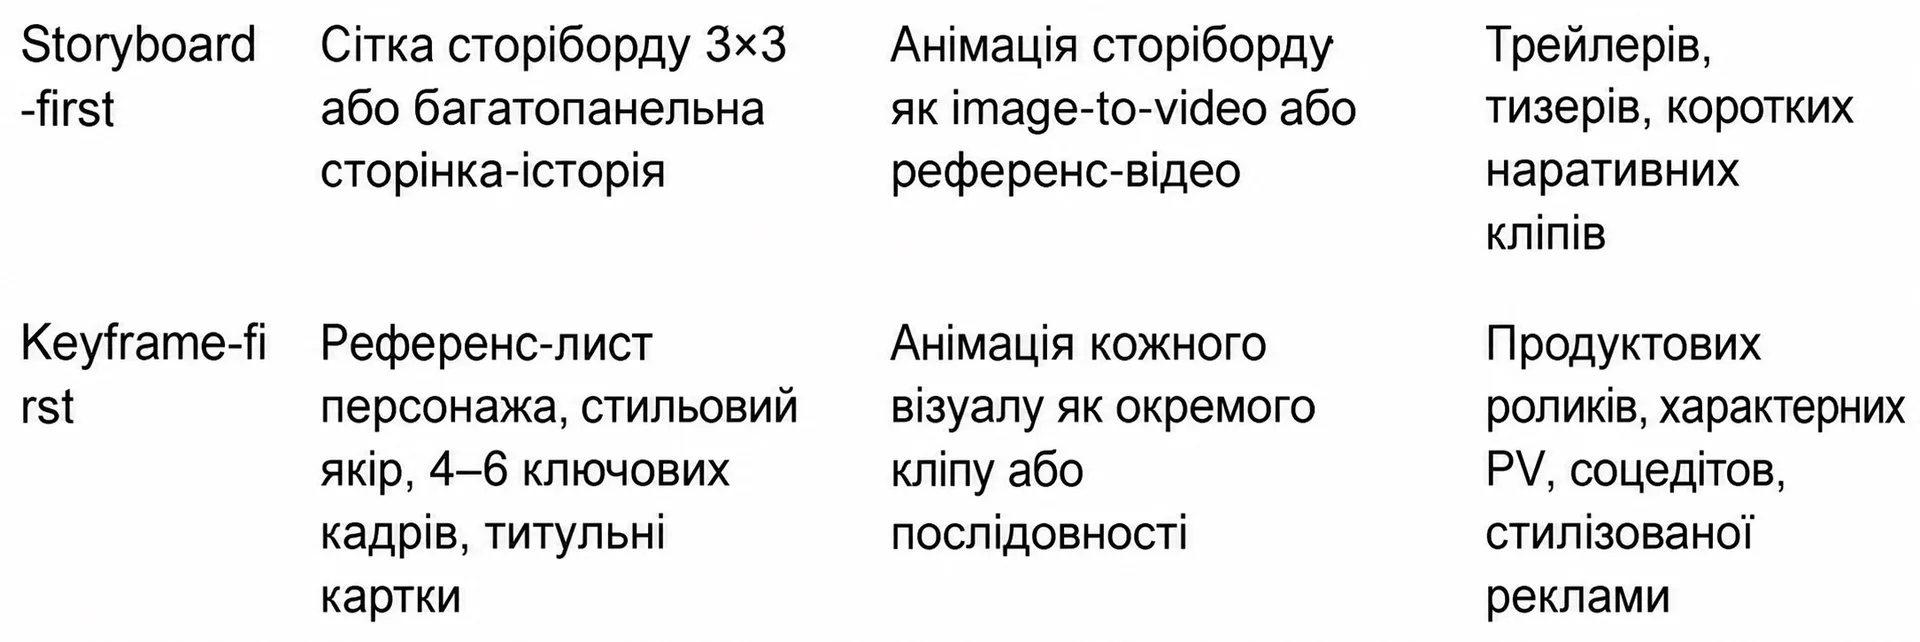 Porównanie podejść Storyboard-first i Keyframe-first — ilustracja 3
| Parametr porównania | Podejście Storyboard-first | Podejście Keyframe-first |
|---|---|---|
| Materiał wyjściowy w GPT Image 2 | Siatka storyboardu 3×3 lub wieloklatkowy arkusz | Zestaw 4–6 osobnych klatek kluczowych i plakatów |
| Metoda animacji w Seedance 2.0 | Animacja całego storyboardu jako ciągłego ujęcia | Sekwencyjna animacja każdej klatki w osobny klip |
| Optymalne obszary zastosowań | Dynamiczne trailery, teasery, krótkie sceny akcji | Przeglądy produktów, filmy fashion, reklamy marek |
| Kontrola kompozycji | Ogólna kontrola tempa i przejść | Maksymalna kontrola pikselowa każdego planu |
5. Praktyczny proces produkcyjny w pięciu krokach
Dla większości zadań komercyjnych wystarczające jest konsekwentne przejście przez pięć kroków.
5.1. Krok 1: Formułowanie listy ujęć i koncepcji reżyserskiej
Przed rozpoczęciem generacji sporządź prosty plan tekstowy sceny (Shot List) z określeniem celów każdego ujęcia:
5.2. Krok 2: Utrwalenie arkuszy referencyjnych i kotwic stylistycznych w GPT Image 2
Wygeneruj arkusz modelowy głównego bohatera (front, profil, detale garderoby) oraz kotwicę kolorystyczną lokacji. To wykluczy rozmywanie wyglądu na kolejnych etapach.
5.3. Krok 3: Składanie siatki storyboardu lub klatek kluczowych
Korzystając z uzyskanych referencji, skompletuj pełny storyboard. Zwracaj uwagę na czytelność planów: zbliżenia powinny kontrastować z ogólnymi krajobrazami, aby stworzyć rytm montażowy.
5.4. Krok 4: Animacja i dynamika kamery w Seedance 2.0
Przekaż storyboard do Seedance 2.0. Prompty na tym etapie formułuj jako instrukcje operatorskie: opisuj kierunek ruchu kamery, prędkość panoramy i reakcje postaci, unikając powtórnego wymieniania szczegółów ubioru.
5.5. Krok 5: Postprodukcja, czołówki i finalny montaż
Otrzymane fragmenty wideo importuj do edytora (Premiere, DaVinci Resolve lub CapCut). Tutaj dodajesz finalne napisy, efekty dźwiękowe (SFX), korekcję kolorów oraz przycinanie ujęć pod tempo muzyki.
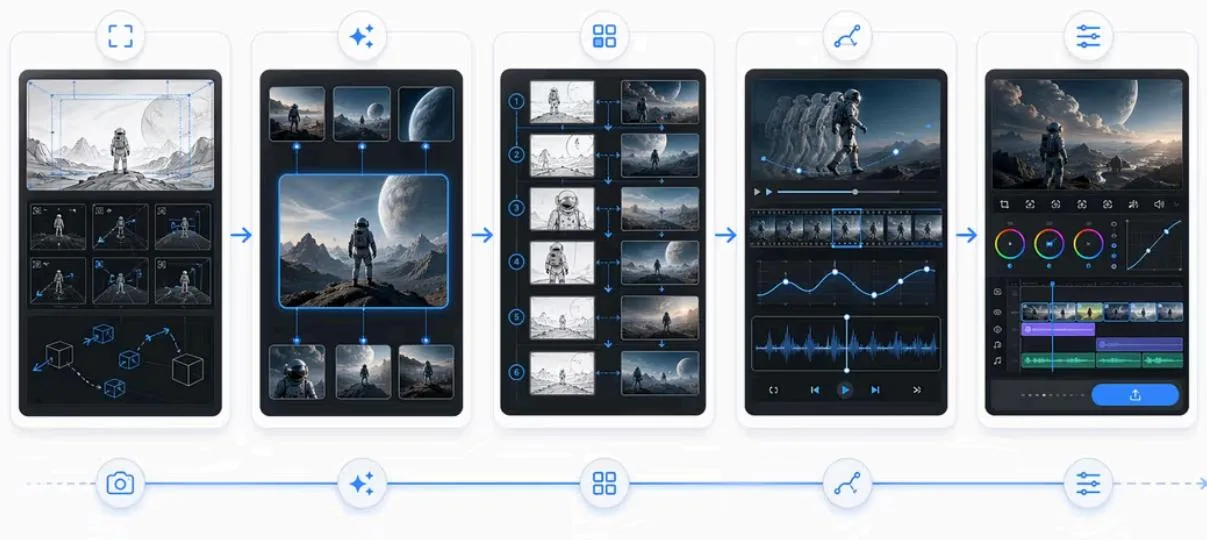 Pełny 5-etapowy cykl rozwoju wideo — ilustracja 4
6. Typowe problemy i metody ich rozwiązania
Omówmy trzy najczęstsze trudności podczas pracy z tym połączeniem oraz praktyczne sposoby ich eliminacji.
6.1. Pojawienie się siatki storyboardu jako pierwszej klatki wideo
- Przyczyna: Jeśli przekażesz siatkę 3×3 w trybie Image-to-Video bez dodatkowych ustawień cropu, sieć neuronowa może potraktować samą siatkę jako pierwszą klatkę i zacząć animować ramki.
- Rozwiązanie: Przytnij pierwszą sekundę podczas finalnego montażu lub wcześniej podziel storyboard na osobne klatki przed importem do Seedance.
6.2. Dryf rysów twarzy i detali wizerunku postaci
- Przyczyna: Próba naprawienia niestabilności wyglądu poprzez zmianę promptu w Seedance 2.0.
- Rozwiązanie: Problem zawsze leży w słabej kotwicy wizualnej na etapie GPT Image 2. Wróć do Kroku 2, utwórz bardziej kontrastowy Character Sheet z wyraźnymi rysami i ponownie wygeneruj klatkę wyjściową.
6.3. Zniekształcenia napisów, naklejek i logotypów w ruchu
- Przyczyna: Sieci neuronowe wideo nie są zdolne do zachowania geometrycznej stabilności drobnych fontów wektorowych podczas ruchu kamery.
- Rozwiązanie: Renderuj sceny bez finalnych napisów. Plansze tekstowe, czołówki i logotypy nakłada się na wygenerowane wideo w programie montażowym.
7. Scenariusze zastosowań: kiedy połączenie sprawdza się najlepiej
To połączenie narzędzi zostało stworzone dla zadań o wysokich wymaganiach co do struktury i spójności kompozycyjnej.
7.1. Macierz zadań: gdzie połączenie daje przewagę, a gdzie jest zbędne
| Zadania i formaty | Efektywność połączenia | Uzasadnienie wyboru |
|---|---|---|
| Kinematograficzne trailery i teasery | Doskonała | Pozwala zachować rytm fabularny i wygląd bohaterów |
| Filmy reklamowe marek i odzieży | Doskonała | Zapewnia dokładne oddanie tkanin, sylwetek i kroju |
| Narracyjne shorty z AI | Doskonała | Gwarantuje stabilność lokacji i rekwizytów między scenami |
| Pojedyncze statyczne ilustracje | Zbędne | Wystarczy tylko funkcjonalność GPT Image 2 |
| Wideo „gadających głów” (prezenterzy) | Nieodpowiednie | Wymaga specjalistycznych modeli lipsync (HeyGen, Hedra) |
| Szybkie jednorazowe szkice | Zbędne | Łatwiej wygenerować bezpośredni klip przez szybki text-to-video |
7.2. Ekonomia czasu i kontrola jakości w projektach
Wykorzystanie wcześniejszej wizualizacji w GPT Image 2 zmniejsza liczbę nieudanych generacji w Seedance o 3–4 razy. Zamiast wydawać kredyty subskrypcyjne na nieprzewidywalne próby wideo, zespół w ciągu kilku minut zatwierdza kompozycję w wersji statycznej, uruchamiając rendering tylko sprawdzonych planów.
8. Często zadawane pytania (FAQ)
8.1. Odpowiedzi na kluczowe pytania dotyczące hybrydowego pipeline
Czy ChatGPT Images 2.0 to to samo co gpt-image-2?
W zasadzie tak. ChatGPT Images 2.0 to marketingowa nazwa produktu interfejsu dla końcowych użytkowników, podczas gdy gpt-image-2 to oficjalny identyfikator modelu w API platformy OpenAI.
Dlaczego nie generować wideo bezpośrednio z tekstu (Text-to-Video)?
Bezpośrednia generacja nadaje się do prostych, pojedynczych klipów. Jednak dla fabularnego rolki z kilkoma ujęciami połączenie ze storyboardem jest jedynym sposobem na uniknięcie ciągłej zmiany twarzy bohatera i deformacji otoczenia.
Od czego lepiej zacząć: od storyboardu czy od klatek kluczowych?
Wybierz storyboard (Storyboard-first), jeśli krytyczna jest dla Ciebie ogólna dynamika i płynne przejścia między planami. Wybierz klatki kluczowe (Keyframe-first), gdy priorytetem jest nienaganna detaliczność i kompozycja każdego osobnego ujęcia.
Czy warto dodawać finalne logotypy na etapie generacji w Seedance?
Nie. Każdy font drukowany w modelach dyfuzyjnych wideo jest podatny na migotanie i zniekształcenia kształtu. Wszystkie graficzne napisy, podpisy i plansze brandowe nakłada się na finalne wideo.