Der Versuch, ein komplexes kinematografisches Video mit einem einzigen Text-Prompt in einer neuronalen Netzwerkanwendung zu generieren, führt häufig zu unscharfen Ergebnissen: Gesichtszüge verändern sich von Sekunde zu Sekunde, Kleidung mutiert und die Kamerabewegung wird unberechenbar.
Die Lösung dieses Problems ist eine hybride Pipeline mit einer klaren Rollenteilung: GPT Image 2 übernimmt Art Direction, Character Design und mehrteilige Storyboards, während Seedance 2.0 für Bewegungsphysik, Kamera-Dynamik und das finale Video-Rendering zuständig ist.
1. Überblick und wesentliche Vorteile der Modell-Kombination
Die Integration zweier spezialisierter Tools eliminiert Zufälligkeiten aus der generativen Videoproduktion.
1.1. Das Konzept der Aufgabenteilung: Pre-Production vs. Animation
- GPT Image 2 (
gpt-image-2) fungiert als Abteilung für Concept Art und Storyboarding: Es erstellt Character Sheets (Modellblätter), Farbpaletten, Szenen-Raster und informationsdichte Kompositionen mit klar lesbarem Text. - Seedance 2.0 agiert als digitaler Operator und Animator: Es wandelt statische visuelle Daten in flüssige 4–15-Sekunden-Clips um, mit steuerbarer Bewegungsgeschwindigkeit und audiovisuellem Begleitmaterial.
Die Kombination der Modelle zeigt stets eine höhere Stabilität als die direkte Text-to-Video-Generierung. Das Videomodell konzentriert sich ausschließlich auf Kinetik und Lichtphysik, ohne Rechenressourcen für die gleichzeitige Entwicklung von Anatomie und Raumgeometrie zu verbrauchen.
1.2. Grundlegende Pipeline vom Idea zur fertigen Video
Der Standardproduktionsprozess folgt einer direkten Abfolge: Formulierung des Shot-Konzepts → Erstellung visueller Anker → Zusammenstellung des Storyboards oder Keyframes → Animation in Seedance 2.0 → Finaler Schnitt und Sound-Mixing.
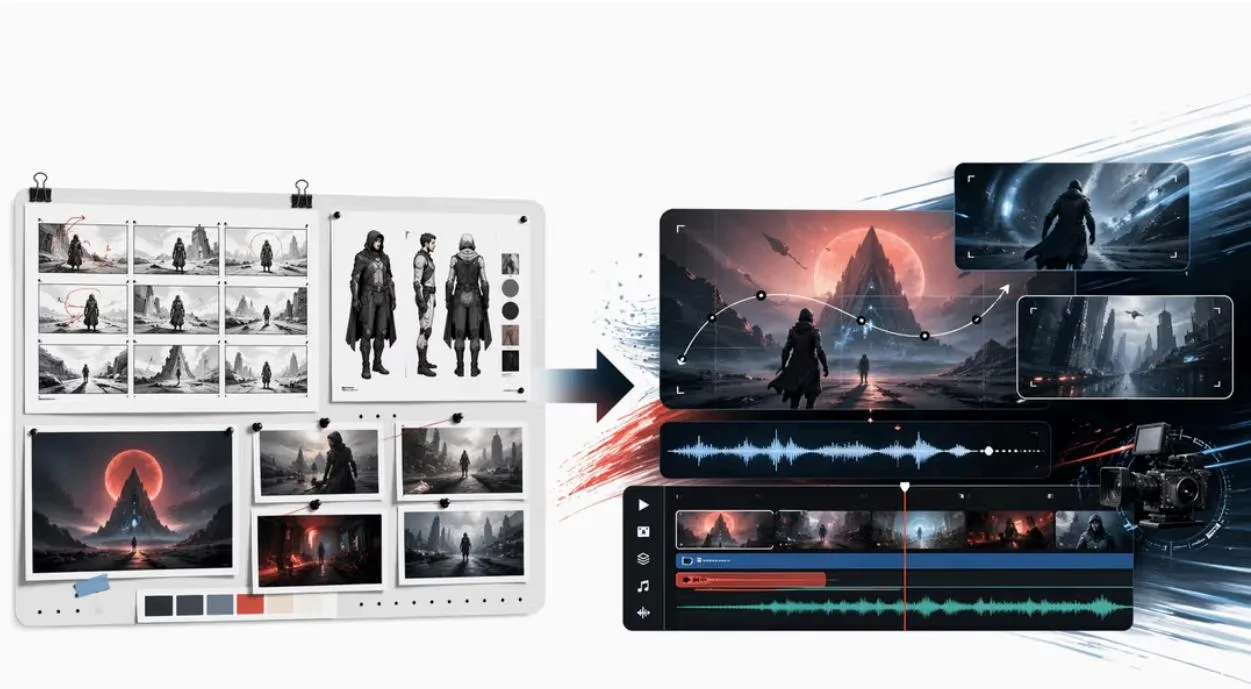 Allgemeines Schema der Pipeline vom Storyboard zur Video-Timeline — Illustration 1
Dieser Ansatz ist unverzichtbar für die Produktion von Trailern, Werbe-Teasern, Produktpräsentationen und stilisierten Clips für Social Media.
2. Was jedes Modell am besten kann
Die Aufgabenverteilung zwischen den Modellen ist am effektivsten entlang der Phasen der Filmproduktion, nicht nach Marketing-Slogans.
2.1. Stärken und Spezialisierung von GPT Image 2
Das Modell GPT Image 2 ist auf Pre-Production optimiert: Generierung hochdetaillierter statischer Szenen, Rendering lesbarer Texte auf Schildern und Titelkarten sowie Aufbau mehrteiliger Comic-Raster und Storyboards. Sein Hauptwert liegt in der Vorhersehbarkeit und der Fixierung des visuellen Stils.
2.2. Fähigkeiten und Fokus von Seedance 2.0
Seedance 2.0 (Entwicklung von BytePlus) unterstützt multimodale Video-Generierung basierend auf Referenzbildern, Audio und Text. Seine Stärke liegt in der Übertragung von Bewegungs-Trägheit, der Einstellung der Kameratrajektorie (Pan, Dolly, Tracking) und der Stabilität der Objektbewegung im Raum.
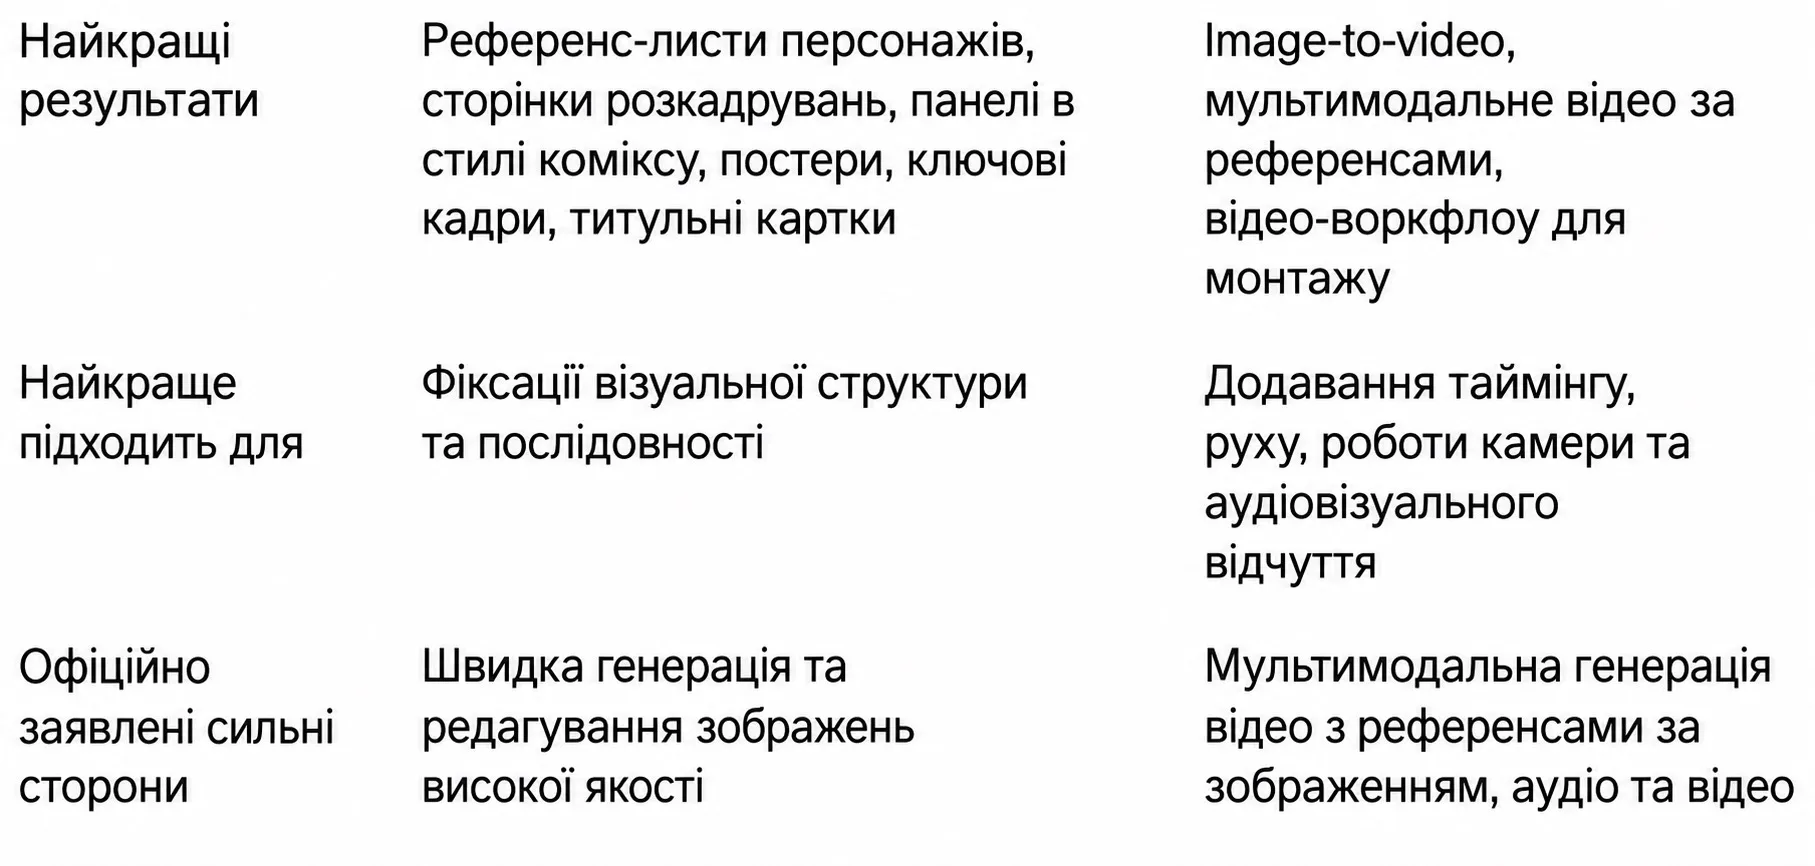 Vergleichstabelle der Modellspezialisierungen — Illustration 2
| Bewertungskriterium | GPT Image 2 (gpt-image-2) | Seedance 2.0 |
|---|---|---|
| Produktionsphase | Visuelle Pre-Production & Art Direction | Animation, Bewegungssimulation & Video-Rendering |
| Eingangsmodalitäten | Textbeschreibung + Referenzbilder | Text, Referenzbilder, Audio und Video |
| Wichtigste Artefakte | Referenzlisten, Storyboards, Poster, Titelkarten | Fertige Clips (4–15 s), Image-to-Video-Animation |
| Haupt-Spezialisierung | Fixierung der visuellen Struktur, Text & Stil | Timing, Kameratrajektorie & Bewegungsphysik |
| Offizielle Vorteile | Schnelle Generierung & Bearbeitung komplexer Bilder | Multimodaler Video-Synthese basierend auf Referenzen |
3. Warum die Kombination besser funktioniert als ein All-in-One-Modell
Die Aufteilung der Aufgaben zwischen den Modellen löst drei Hauptprobleme der generativen Videoerstellung.
3.1. Frühzeitige Sicherstellung der visuellen Konsistenz der Charaktere
Ein direkter Video-Generator muss in einem Durchgang Anatomie, Kostümmaterialien, Beleuchtung und Laufbahn berechnen. Wenn das Team das Character Sheet des Helden in GPT Image 2 fixiert, erhält Seedance einen harten visuellen Anker, der zufällige Mutationen und Gesichtsdrifts zwischen den Frames ausschließt.
3.2. Vereinfachte Kontrolle über Tempo und Schnitt-Bits
Die Erstellung eines 3×3-Storyboard-Rasters oder einer Sequenz von Keyframes ermöglicht es dem Regisseur, den Erzählrhythmus zu genehmigen, bevor die ressourcenintensive Video-Generierung startet:
- Liste der erforderlichen Shots festlegen (Wide, Medium, Detail).
- Visuelle Komposition jedes Frames im statischen Zustand bewerten.
- Frames an das Videomodell übergeben, um Bewegung hinzuzufügen.
3.3. Erhaltung komplexer Typografie und Layouts
GPT Image 2 bewältigt gedruckte Texte, Logos auf Kleidung und grafische Banner hervorragend. Die Generierung dieser Elemente direkt in Videomodellen ruft fast immer „Verschwimm“-Artefakte der Buchstaben hervor. Die Vorbereitung statischer Titelkarten beseitigt dieses Problem vollständig.
4. Standard-Workflows: Storyboard-first vs. Keyframe-first
Je nach Projektzielen teilt sich die Produktionspipeline in zwei grundlegende Modelle.
4.1. Storyboard-first-Pattern: Für dynamische Trailer und Narrative
Im Storyboard-first-Ansatz generiert GPT Image 2 eine einzelne mehrteilige Seite (3×3-Raster oder horizontales 16:9-Band), auf der alle Episoden chronologisch angeordnet sind. Dieses Blatt wird als einziger multimodaler Referenzdatensatz in Seedance 2.0 hochgeladen, wodurch das Videomodell durchgehende Kamerabewegungen über die gesamte Szene hinweg beibehält.
4.2. Keyframe-first-Pattern: Für detaillierte Frame-by-Frame-Kontrolle
Im Keyframe-first-Ansatz wird jeder Frame des zukünftigen Videos als separates Hochqualitätsbild mit präziser Einstellung von Beleuchtung und Pose erstellt. Anschließend wird jeder Frame in Seedance 2.0 als unabhängiges 3–5-Sekunden-Fragment animiert, und der finale Zusammenschnitt erfolgt in einem Video-Editor.
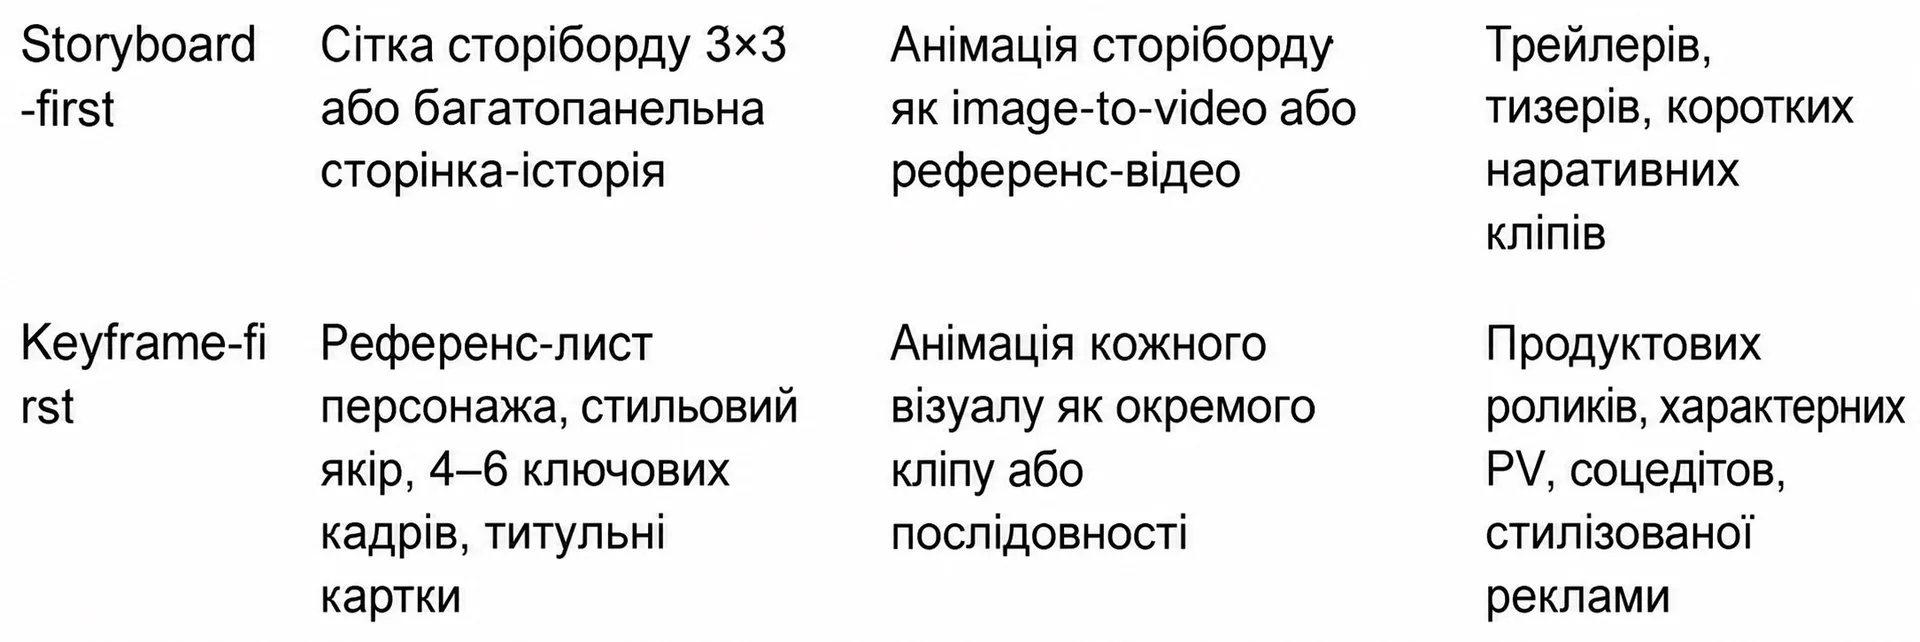 Vergleich der Ansätze Storyboard-first und Keyframe-first — Illustration 3
| Vergleichsparameter | Storyboard-first-Ansatz | Keyframe-first-Ansatz |
|---|---|---|
| Ausgangsmaterial in GPT Image 2 | Storyboard-Raster 3×3 oder mehrteiliges Blatt | Satz von 4–6 separaten Keyframes und Postern |
| Animierungsmethode in Seedance 2.0 | Animierung des gesamten Storyboards als durchgehender Take | Sequenzielle Animierung jedes Frames als separater Clip |
| Optimale Anwendungsbereiche | Dynamische Trailer, Teaser, kurze Action-Szenen | Produktreviews, Fashion-Videos, Markenwerbung |
| Kompositionskontrolle | Allgemeine Kontrolle über Tempo und Übergänge | Maximale pixelgenaue Kontrolle jedes einzelnen Shots |
5. Praktischer Produktionsprozess in fünf Schritten
Für die meisten kommerziellen Aufgaben reicht das sequentielle Durchlaufen von fünf Schritten aus.
5.1. Schritt 1: Erstellung der Shot-Liste und des Regiekonzepts
Erstellen Sie vor Beginn der Generierung einen einfachen textlichen Szenenplan (Shot List) mit Festlegung der Ziele jedes Frames:
5.2. Schritt 2: Fixierung der Referenzlisten und Stilanker in GPT Image 2
Generieren Sie das Character Sheet der Hauptfigur (Frontal, Profil, Garderobendetails) und den Farbanker der Location. Dies verhindert das Verwischen des Aussehens in späteren Phasen.
5.3. Schritt 3: Zusammenstellung des Storyboard-Rasters oder der Keyframes
Nutzen Sie die erhaltenen Referenzen, um das vollständige Storyboard zu formen. Achten Sie auf die Klarheit der Shots: Nahaufnahmen müssen mit Gesamtlandschaften kontrastieren, um einen Schnitt-Rhythmus zu erzeugen.
5.4. Schritt 4: Animation und Kamera-Dynamik in Seedance 2.0
Übergeben Sie das Storyboard an Seedance 2.0. Prompts für diese Phase werden als Operator-Anweisungen formuliert: Beschreiben Sie die Richtung der Kamerabewegung, die Geschwindigkeit des Pans und die Reaktion der Charaktere, wobei Sie eine erneute Auflistung der Kleidungsdetails vermeiden.
5.5. Schritt 5: Post-Production, Credits und finaler Schnitt
Die erhaltenen Video-Fragmente werden in einen Video-Editor importiert (Premiere, DaVinci Resolve oder CapCut). Hier werden finale Schriftzüge, Sound-Effekte (SFX), Farbkorrektur und das Trimmen der Frames an das Musiktempo hinzugefügt.
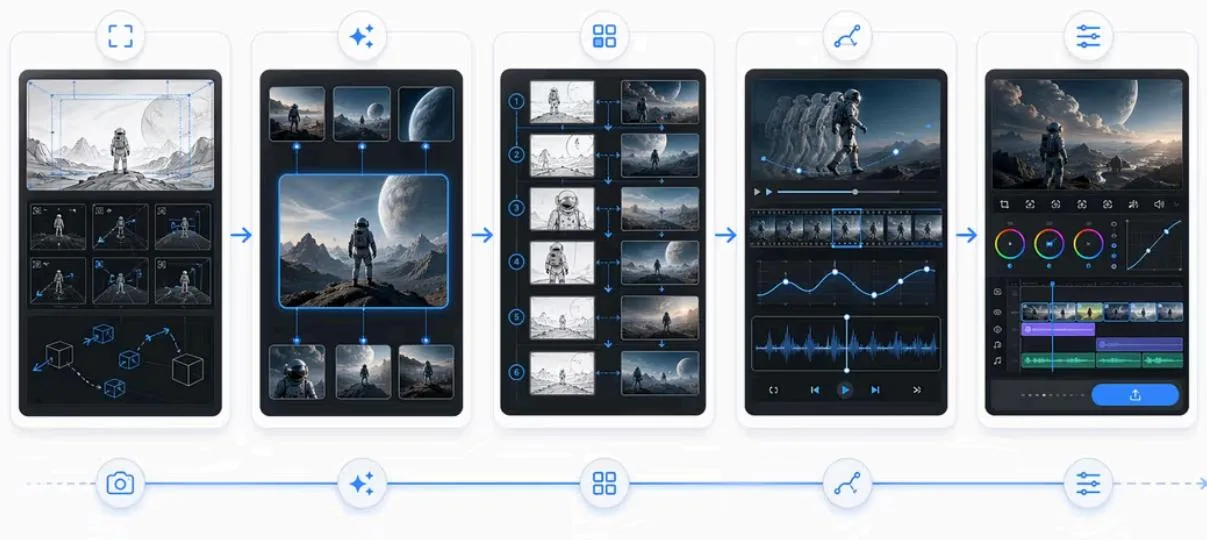 Vollständiger 5-stufiger Zyklus der Videoentwicklung — Illustration 4
6. Typische Probleme und Lösungswege
Betrachten wir drei der häufigsten Schwierigkeiten bei der Arbeit mit dieser Kombination und praktische Wege zu ihrer Behebung.
6.1. Erscheinen des Storyboard-Rasters als erster Frame im Video
- Ursache: Wenn das 3×3-Raster im Image-to-Video-Modus ohne zusätzliche Crop-Einstellungen übergeben wird, kann das neuronale Netzwerk das Raster selbst als ersten Frame interpretieren und beginnen, die Rahmen zu animieren.
- Lösung: Schneiden Sie die erste Sekunde beim finalen Montage heraus oder zerschneiden Sie das Storyboard vor dem Import in Seedance in separate Frames.
6.2. Drift der Gesichtszüge und Details des Charakter-Looks
- Ursache: Der Versuch, die Instabilität des Aussehens durch Änderung des Prompts in Seedance 2.0 zu korrigieren.
- Lösung: Das Problem liegt immer in einem schwachen visuellen Anker in der GPT Image 2-Phase. Kehren Sie zu Schritt 2 zurück, erstellen Sie ein kontrastreicheres Character Sheet mit klaren Zügen und regenerieren Sie den Ausgangsframe erneut.
6.3. Verzerrung von Schriftzügen, Bannern und Logos in Bewegung
- Ursache: Neuronale Video-Modelle sind nicht in der Lage, die geometrische Stabilität kleiner Vektor-Schriften während der Kamerabewegung zu erhalten.
- Lösung: Rendern Sie Szenen ohne finale Credits. Textbanner, Untertitel und Logo-Overlays werden in der Schnittsoftware über das generierte Video gelegt.
7. Anwendungsfälle: Wann die Kombination am besten geeignet ist
Die Tool-Kombination wurde für Aufgaben entwickelt, die hohe Anforderungen an Struktur und kompositorische Integrität stellen.
7.1. Aufgabenmatrix: Wo die Kombination Vorteile bringt und wo sie redundant ist
| Aufgabe und Format | Effizienz der Kombination | Begründung der Wahl |
|---|---|---|
| Kinematografische Trailer & Teaser | Exzellent | Ermöglicht die Beibehaltung des erzählerischen Rhythmus und des Heldenaussehens |
| Werbevideos für Marken & Mode | Exzellent | Sichert die genaue Wiedergabe von Stoffen, Silhouetten und Schnitten |
| Narrative KI-Kurzfilme | Exzellent | Garantiert die Stabilität von Locations und Requisiten zwischen den Szenen |
| Einzelne statische Illustrationen | Redundant | Nur die Funktionalität von GPT Image 2 ist erforderlich |
| „Talking Head“-Videos (Sprecher) | Ungeeignet | Erfordert spezialisierte Lip-Sync-Modelle (HeyGen, Hedra) |
| Schnelle Einweg-Entwürfe | Redundant | Einfacher, einen direkten Clip via schnellem Text-to-Video zu generieren |
7.2. Zeitökonomie und Qualitätskontrolle in Projekten
Die Verwendung der Vorvisualisierung in GPT Image 2 reduziert die Anzahl fehlgeschlagener Generierungen in Seedance um das 3–4-fache. Anstatt Abonnement-Credits für unberechenbare Video-Versuche zu verschwenden, genehmigt das Team die Komposition im statischen Zustand innerhalb weniger Minuten und startet das Rendering nur für geprüfte Shots.
8. Häufig gestellte Fragen (FAQ)
8.1. Antworten auf Schlüsselfragen zum kombinierten Pipeline
Ist ChatGPT Images 2.0 dasselbe wie gpt-image-2?
Im Wesentlichen ja. ChatGPT Images 2.0 ist der marketingseitige Produktname der Benutzeroberfläche für Endnutzer, während gpt-image-2 der offizielle Modell-Identifier in der API der OpenAI-Plattform ist.
Warum nicht Videos direkt aus Text generieren (Text-to-Video)?
Direkte Generierung eignet sich für einfache Einzelclips. Für narrative Videos mit mehreren Frames ist die Kombination mit Storyboard jedoch der einzige Weg, um ständige Veränderungen des Heldengesichts und Deformationen der Umgebung zu vermeiden.
Womit sollte man beginnen: Mit dem Storyboard oder mit Keyframes?
Wählen Sie das Storyboard (Storyboard-first), wenn Ihnen die allgemeine Dynamik und weiche Übergänge zwischen den Shots wichtig sind. Wählen Sie Keyframes (Keyframe-first), wenn makellose Detailgenauigkeit und Komposition jedes einzelnen Shots Priorität haben.
Sollte man finale Logos in der Generierungsphase in Seedance hinzufügen?
Nein. Jeder gedruckte Font in Video-Diffusionsmodellen neigt zu Flackern und Formverzerrungen. Alle grafischen Schriftzüge, Untertitel und Branding-Banner werden in der finalen Schnittphase überlagert.