Tentar gerar um vídeo cinematográfico complexo com um único prompt de texto em uma rede neural frequentemente resulta em outputs inconsistentes: os traços faciais mudam entre os segundos, a roupa se transforma e o movimento da câmera torna-se imprevisível.
A solução para esse problema é um pipeline híbrido com papéis bem definidos: o GPT Image 2 assume a direção de arte, o design de personagens e os storyboards multi-painel, enquanto o Seedance 2.0 cuida da física do movimento, da dinâmica da câmera e do render final do vídeo.
1. Visão geral e principais vantagens da combinação de modelos
Integrar duas ferramentas especializadas permite eliminar a aleatoriedade na produção generativa de vídeos.
1.1. Conceito de separação de responsabilidades: pré-produção versus animação
- O GPT Image 2 (
gpt-image-2) assume as funções do departamento de concept art e storyboard: gera folhas de modelo (character sheets) dos personagens, paletas de cores, grades de cenas e composições densas em informação com texto nítido. - O Seedance 2.0 atua como operador digital e animador: converte dados visuais estáticos em clipes fluidos de 4 a 15 segundos, com controle de velocidade de movimento e acompanhamento audiovisual.
A combinação de modelos sempre demonstra maior estabilidade do que a geração direta text-to-video. O modelo de vídeo foca exclusivamente na cinemática e na física da luz, sem gastar recursos computacionais desenvolvendo simultaneamente a anatomia dos heróis e a geometria do espaço.
1.2. Pipeline básico da ideia ao vídeo pronto
O processo padrão de produção segue uma linha direta: definição da intenção das cenas → criação de âncoras visuais → montagem do storyboard ou keyframes → animação no Seedance 2.0 → edição final e sobreposição de áudio.
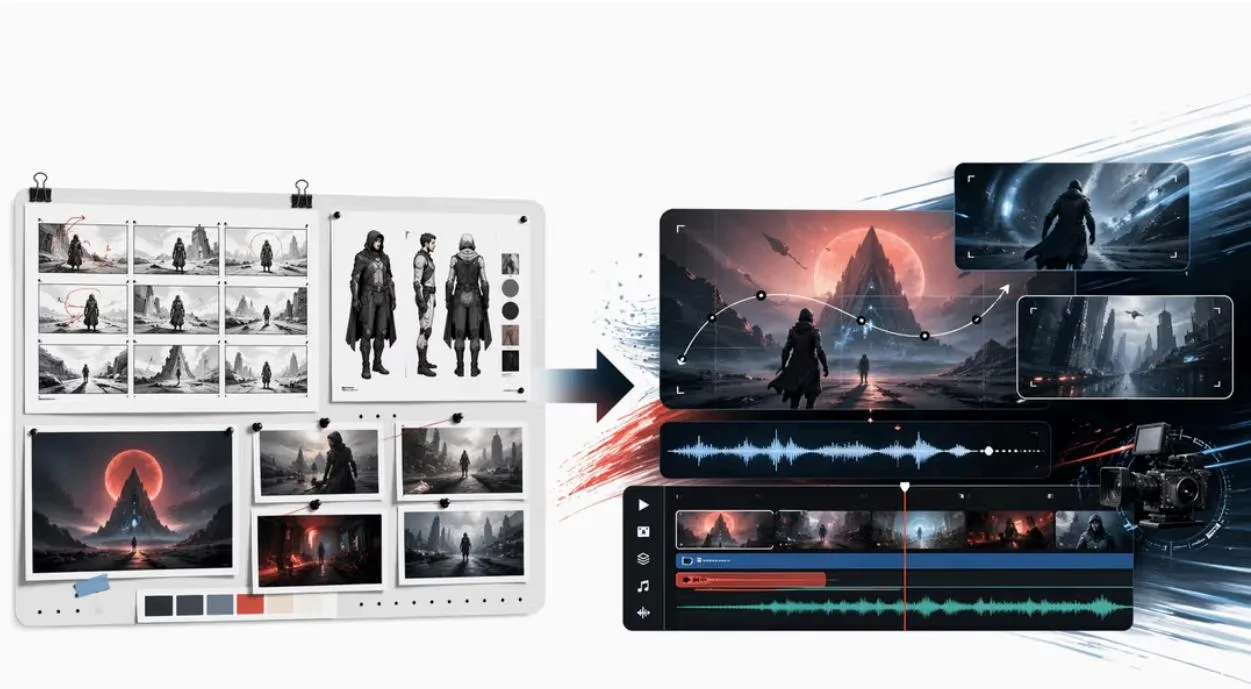 Diagrama geral do pipeline do storyboard à timeline do vídeo — ilustração 1
Essa abordagem é indispensável para a produção de trailers, teasers publicitários, apresentações de produtos e vídeos estilizados para redes sociais.
2. O que cada modelo faz melhor
Distribuir tarefas entre os modelos é mais eficiente quando feito por etapas da produção cinematográfica, e não por slogans de marketing.
2.1. Pontos fortes e especialização do GPT Image 2
O modelo GPT Image 2 é otimizado para a pré-produção: geração de cenas estáticas altamente detalhadas, renderização de texto legível em letreiros e cartões de título, além da construção de grades de quadrinhos e storyboards multi-frame. Seu principal valor reside na previsibilidade e na fixação do estilo visual.
2.2. Capacidades e foco do Seedance 2.0
O Seedance 2.0 (desenvolvido pela BytePlus) suporta geração multimodal de vídeo baseada em imagens de referência, áudio e texto. Sua força está na transmissão da inércia do movimento, ajuste da trajetória da câmera (pan, dolly, tracking) e estabilidade do deslocamento de objetos no espaço.
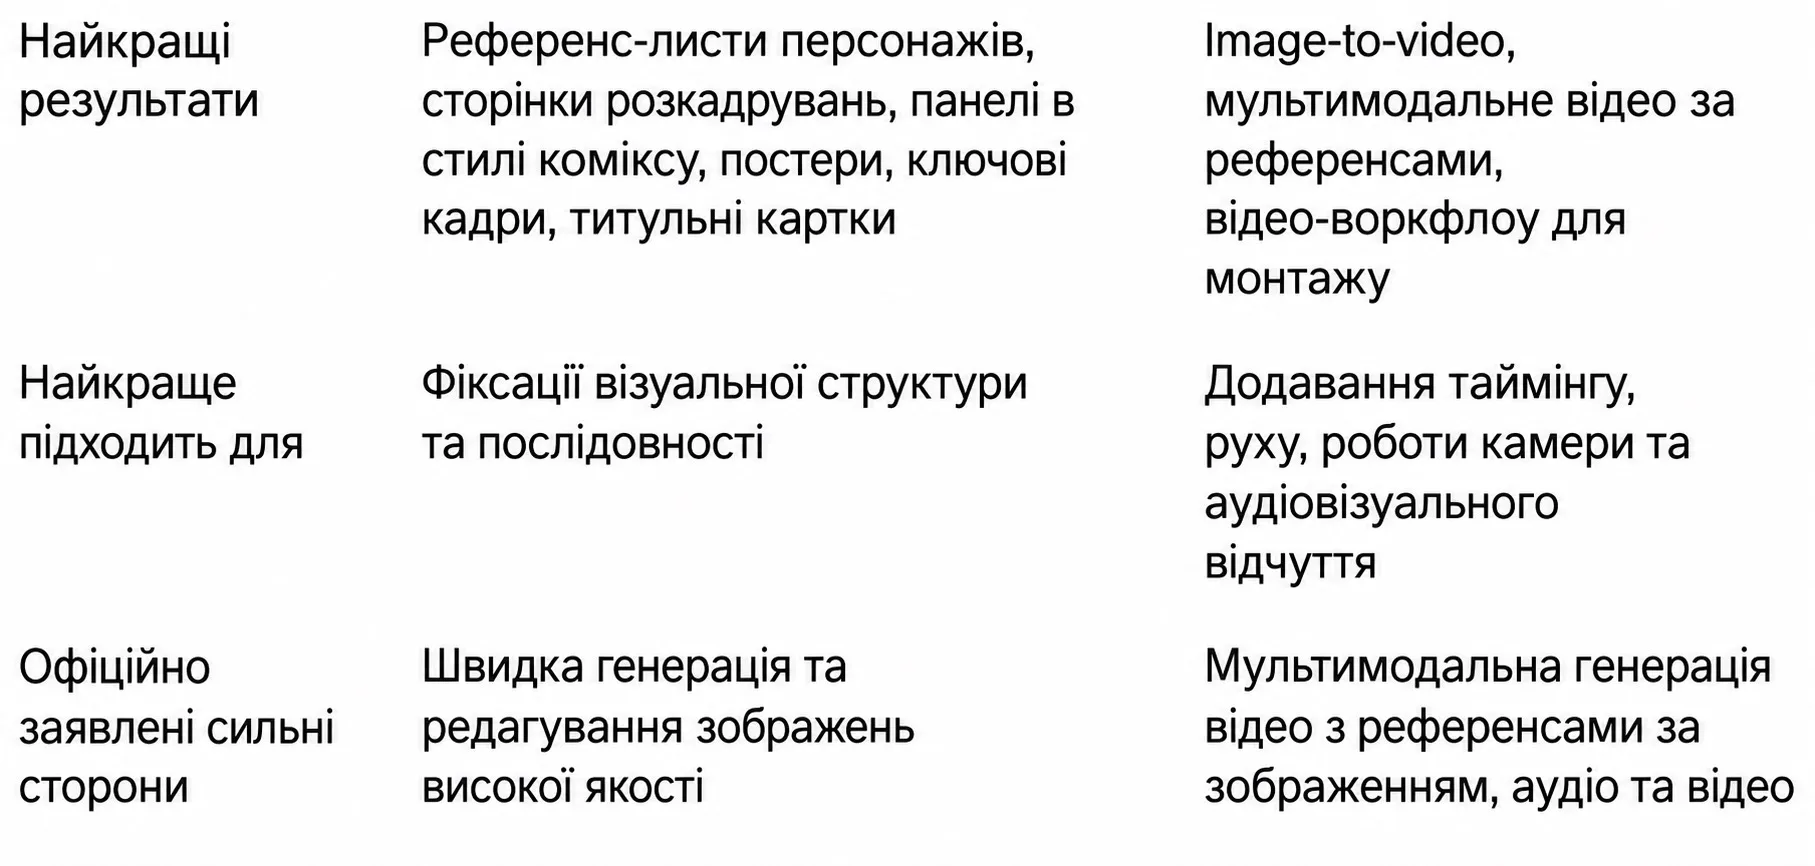 Tabela comparativa da especialização dos modelos — ilustração 2
| Critério de avaliação | GPT Image 2 (gpt-image-2) | Seedance 2.0 |
|---|---|---|
| Etapa da produção | Pré-produção visual e direção de arte | Animação, simulação de movimento e render de vídeo |
| Modalidades de entrada | Descrição textual + imagens de referência | Texto, imagens de referência, áudio e vídeo |
| Artefatos-chave | Listas de referências, storyboards, posters, cartões de título | Clipes prontos (4–15 s), animação image-to-video |
| Especialização principal | Fixação da estrutura visual, texto e estilo | Timing, trajetória da câmera e física do movimento |
| Vantagens oficiais | Geração rápida e edição de imagens complexas | Síntese multimodal de vídeo baseada em referências |
3. Por que a combinação funciona melhor do que um único modelo universal
A divisão de tarefas entre os modelos resolve três dos principais problemas do vídeo generativo.
3.1. Ancoragem precoce da consistência visual dos personagens
Um gerador de vídeo direto precisa calcular, em uma única passada, a anatomia, os materiais do traje, a iluminação e a trajetória da corrida. Quando a equipe fixa a folha de modelo do herói no GPT Image 2, o Seedance recebe uma âncora visual rígida, eliminando mutações aleatórias e drift facial entre os quadros.
3.2. Simplificação do controle sobre o ritmo e cortes de edição
Criar uma grade de storyboard 3×3 ou uma sequência de keyframes permite que o diretor aprove o ritmo narrativo antes de iniciar a geração de vídeo, que consome muitos recursos:
- Definir a lista de planos obrigatórios (plano geral, plano médio, close-up).
- Avaliar a composição visual de cada quadro em estado estático.
- Enviar os quadros para o modelo de vídeo para adicionar movimento.
3.3. Preservação de tipografia complexa e layouts
O GPT Image 2 lida excepcionalmente bem com texto impresso, logos em roupas e blocos gráficos. Gerar esses elementos diretamente nos modelos de vídeo quase sempre causa artefatos de "borramento" das letras. Preparar cartões de título estáticos elimina completamente esse problema.
4. Workflows padrão: Storyboard-first versus Keyframe-first
Dependendo dos objetivos do projeto, o pipeline de produção divide-se em dois modelos básicos.
4.1. Padrão Storyboard-first: para trailers dinâmicos e narrativas
Na abordagem Storyboard-first, o GPT Image 2 gera uma única página multi-painel (grade 3×3 ou faixa horizontal 16:9), onde todos os episódios estão alinhados cronologicamente. Essa folha é carregada no Seedance 2.0 como uma única referência multimodal, permitindo que o modelo de vídeo mantenha um movimento contínuo da câmera através de toda a cena.
4.2. Padrão Keyframe-first: para controle detalhado quadro a quadro
Na abordagem Keyframe-first, cada quadro do futuro vídeo é criado como uma imagem individual de alta qualidade, com ajuste preciso de iluminação e pose. Em seguida, cada quadro é animado no Seedance 2.0 como um fragmento independente de 3–5 segundos, e a junção final é realizada em um editor de vídeo.
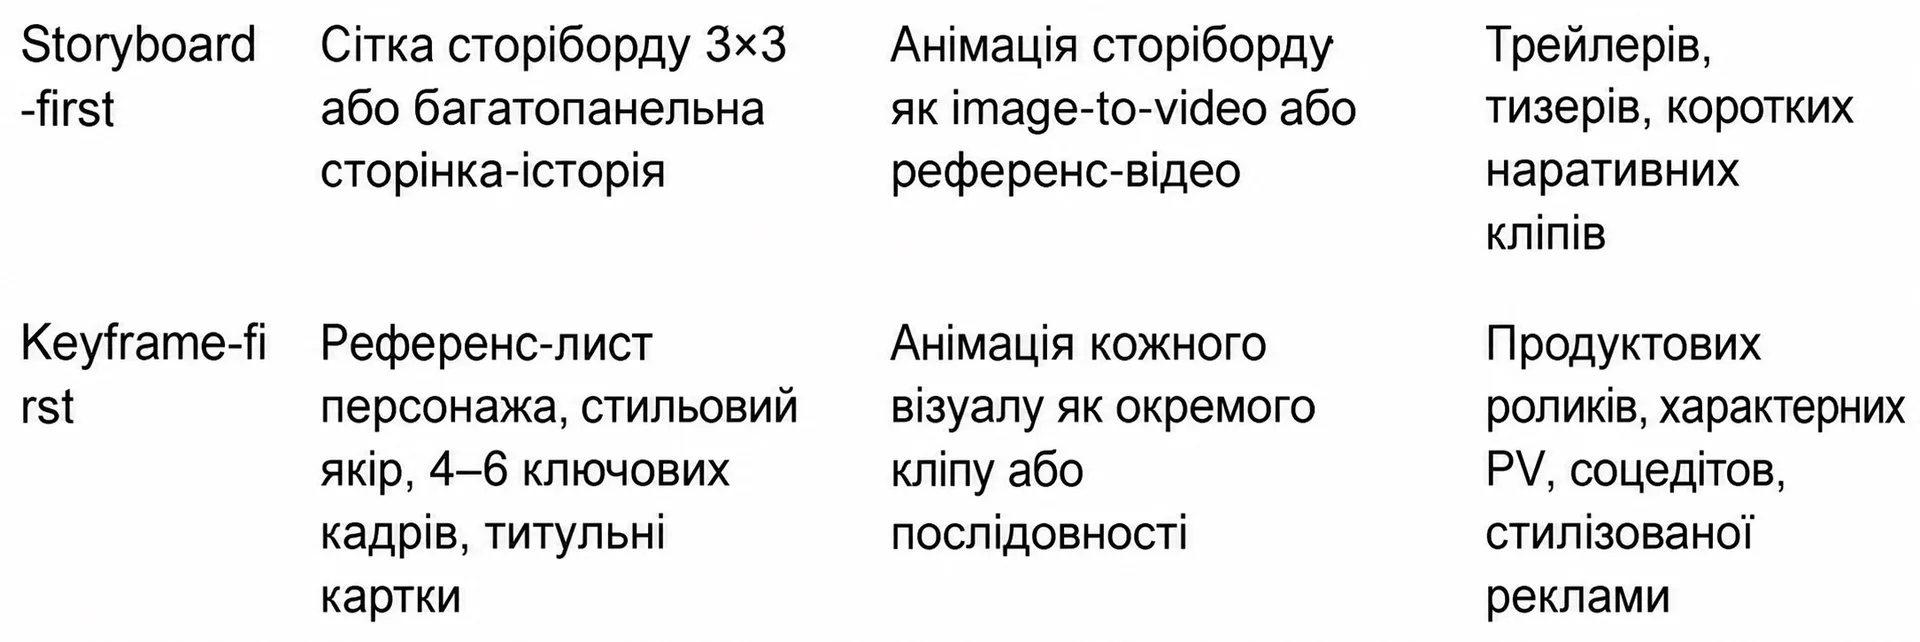 Comparação das abordagens Storyboard-first e Keyframe-first — ilustração 3
| Parâmetro de comparação | Abordagem Storyboard-first | Abordagem Keyframe-first |
|---|---|---|
| Material de origem no GPT Image 2 | Grade de storyboard 3×3 ou folha multi-painel | Conjunto de 4–6 keyframes e posters individuais |
| Método de animação no Seedance 2.0 | Animação de todo o storyboard como um take contínuo | Animação sequencial de cada quadro em um clipe separado |
| Áreas de aplicação ideais | Trailers dinâmicos, teasers, cenas curtas de ação | Reviews de produtos, vídeos fashion, publicidade de marcas |
| Controle de composição | Controle geral do ritmo e transições | Controle máximo pixel a pixel de cada plano |
5. Processo prático de produção em cinco etapas
Para a maioria das tarefas comerciais, basta seguir rigorosamente os cinco passos abaixo.
5.1. Passo 1: Formação da lista de planos e da intenção do diretor
Antes de iniciar a geração, crie um plano textual simples da cena (Shot List) fixando os objetivos de cada quadro:
5.2. Passo 2: Fixação das listas de referência e âncoras de estilo no GPT Image 2
Gere a folha de modelo do personagem principal (frente, perfil, detalhes do guarda-roupa) e a âncora de cor do local. Isso evitará o desfoque da aparência externa nas etapas subsequentes.
5.3. Passo 3: Montagem da grade de storyboard ou keyframes
Usando as referências obtidas, forme o storyboard completo. Preste atenção à nitidez dos planos: closes devem contrastar com planos gerais para criar ritmo de edição.
5.4. Passo 4: Animação e dinâmica de câmera no Seedance 2.0
Envie o storyboard para o Seedance 2.0. Os prompts para esta etapa são formulados como instruções de operador de câmera: descreva a direção do movimento da câmera, a velocidade do pan e a reação dos personagens, evitando repetir detalhes da roupa.
5.5. Passo 5: Pós-produção, créditos e finalização da edição
Os fragmentos de vídeo obtidos são importados para um editor de vídeo (Premiere, DaVinci Resolve ou CapCut). Aqui são adicionados textos finais, efeitos sonoros (SFX), correção de cor e ajustes de corte dos quadros conforme o tempo da música.
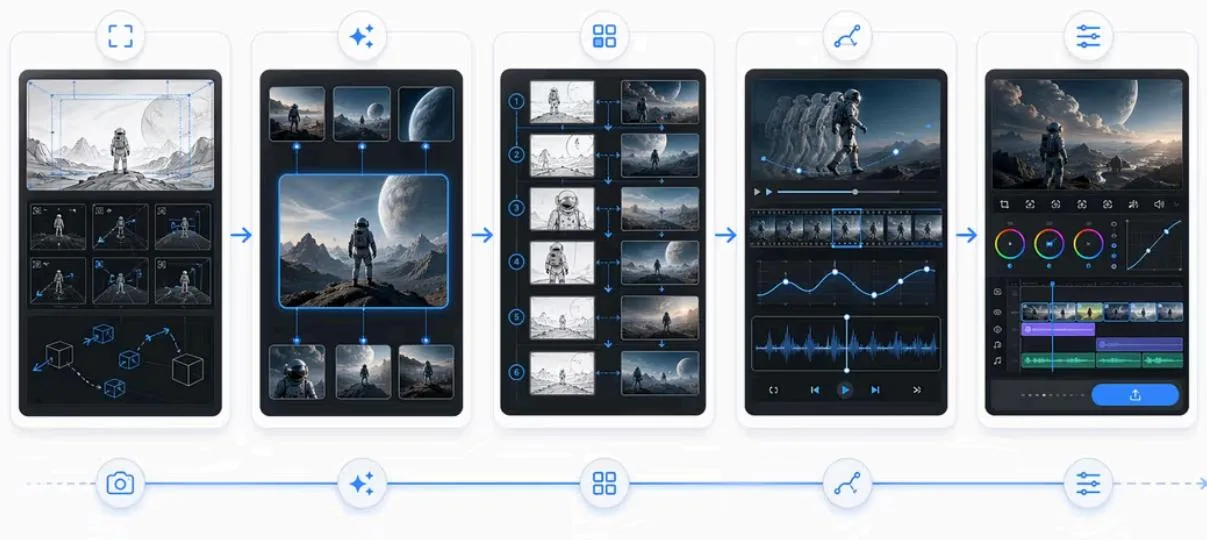 Ciclo completo de desenvolvimento de vídeo em 5 etapas — ilustração 4
6. Problemas comuns e métodos de resolução
Vamos analisar três dificuldades frequentes ao trabalhar com essa combinação e caminhos práticos para solucioná-las.
6.1. Aparecimento da grade do storyboard como primeiro quadro do vídeo
- Causa: Se você enviar uma grade 3×3 no modo Image-to-Video sem configurações adicionais de crop, a rede neural pode interpretar a própria grade como o primeiro quadro e começar a animar as bordas.
- Solução: Corte o primeiro segundo durante a edição final ou divida previamente o storyboard em quadros individuais antes de importar para o Seedance.
6.2. Drift dos traços faciais e detalhes do visual do personagem
- Causa: Tentativa de corrigir a instabilidade da aparência alterando o prompt no Seedance 2.0.
- Solução: O problema reside sempre em uma âncora visual fraca na etapa do GPT Image 2. Volte ao Passo 2, crie uma Character Sheet mais contrastante com traços definidos e regere o quadro original.
6.3. Distorção de textos, banners e logos em movimento
- Causa: Modelos de vídeo neurais não conseguem manter a estabilidade geométrica de fontes vetoriais pequenas durante o movimento da câmera.
- Solução: Renderize as cenas sem os créditos finais. Banners de texto, títulos e logos são sobrepostos ao vídeo gerado no software de edição.
7. Cenários de uso: quando a combinação é ideal
A integração de ferramentas foi criada para tarefas com altas exigências de estrutura e integridade composicional.
7.1. Matriz de tarefas: onde a combinação traz vantagem e onde é excessiva
| Tarefas e formatos | Eficácia da combinação | Justificativa da escolha |
|---|---|---|
| Trailers e teasers cinematográficos | Excelente | Permite manter o ritmo narrativo e a aparência dos heróis |
| Vídeos publicitários de marcas e moda | Excelente | Garante a transmissão precisa de tecidos, silhuetas e cortes |
| Curta-metragens narrativos com IA | Excelente | Garante a estabilidade de locações e adereços entre as cenas |
| Ilustrações estáticas isoladas | Excessivo | Basta apenas a funcionalidade do GPT Image 2 |
| Vídeos de "cabeças falantes" (apresentadores) | Inadequado | Requer modelos especializados de lip-sync (HeyGen, Hedra) |
| Rascunhos rápidos descartáveis | Excessivo | É mais simples gerar um clipe direto via text-to-video rápido |
7.2. Economia de tempo e controle de qualidade nos projetos
O uso da pré-visualização no GPT Image 2 reduz em 3 a 4 vezes o número de gerações malsucedidas no Seedance. Em vez de gastar créditos de assinatura em tentativas de vídeo imprevisíveis, a equipe aprova a composição em estado estático em poucos minutos, iniciando o render apenas dos planos verificados.
8. Perguntas Frequentes (FAQ)
8.1. Respostas às principais dúvidas sobre o pipeline combinado
ChatGPT Images 2.0 é o mesmo que gpt-image-2?
Essencialmente, sim. ChatGPT Images 2.0 é o nome comercial do produto para a interface do usuário final, enquanto gpt-image-2 é o identificador oficial do modelo na API da plataforma OpenAI.
Por que não gerar o vídeo diretamente do texto (Text-to-Video)?
A geração direta serve para clipes simples e isolados. No entanto, para um vídeo narrativo com múltiplos quadros, a combinação com storyboard é a única forma de evitar mudanças constantes no rosto do herói e deformações do ambiente.
De onde é melhor começar: do storyboard ou dos keyframes?
Escolha o storyboard (Storyboard-first) se a dinâmica geral e as transições suaves entre planos forem críticas para você. Escolha os keyframes (Keyframe-first) quando a prioridade for a perfeição dos detalhes e da composição de cada plano individual.
Devo adicionar logos finais na etapa de geração no Seedance?
Não. Qualquer fonte impressa em modelos de difusão de vídeo tende a piscar e distorcer sua forma. Todos os textos gráficos, legendas e banners de marca devem ser sobrepostos na etapa final de edição.