Lanzamiento de Qwen3.8-Omni-Flash: Modelo multimodal con contexto de 1M tokens
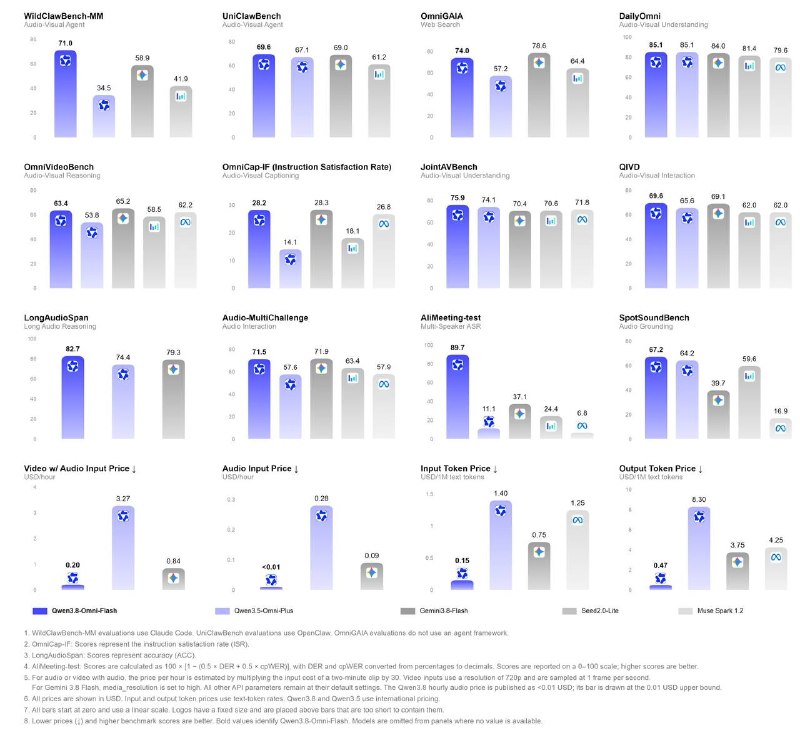
Qwen ha lanzado Qwen3.8-Omni-Flash, un modelo multimodal con una ventana de contexto de 1 millón de tokens, mejor comprensión de video y costos significativamente reducidos para audio y video.
Lanzamiento de Qwen3.8-Omni-Flash
Los desarrolladores la llaman el primer modelo multimodal de la línea construido alrededor de capacidades agénticas. Comprende texto, imágenes, audio y video como entrada, con una ventana de contexto de 1 millón de tokens.
Se ha mejorado significativamente la comprensión y el procesamiento de video: el modelo comprende mucho mejor los videos largos, puede generar informes de investigación profunda o subtítulos basados en ellos y no alucina códigos de tiempo. Mientras tanto, las capacidades de texto se mantienen al nivel de la Qwen-3.8 Flash estándar.
En general, este modelo está diseñado como un eslabón intermedio para un futuro pipeline completo para escenarios como edición de video, traducción, comentarios de películas, creación de contenido, etc.
En comparación con la anterior Qwen3.5-Omni-Flash, el consumo de tokens también ha disminuido significativamente y el precio ha bajado:
- El procesamiento de audio es un 98% más barato;
- El procesamiento de audio-video es más de un 93% más barato.
Esto se logra con un rendimiento comparable al de Gemini 3.8 Flash.
El modelo ya está disponible en la API y en Qwen Chat.
Por qué es importante
AnálisisEste lanzamiento es vital para desarrolladores de IA que trabajan con datos multimodales, ofreciendo alto rendimiento y capacidades agénticas a una fracción del costo anterior, especialmente para aplicaciones centradas en video.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Google Gemini Pro (Modelo de Google con Contexto Infinito)
Modelo de trabajo principal de Google DeepMind con una ventana de contexto récord de más de 2 millones de tokens. Capaz de analizar libros completos, grabaciones de video y enormes bases de código en una sola consulta.
Gemini Flash & Pro (Google Gemini)
Familia de modelos multimodales de Google DeepMind que combina una ventana de contexto récord (hasta 2 millones de tokens), velocidad de generación extrema (más de 150 tokens/s) y percepción nativa de video y audio.
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.
Investigadores del MIT muestran que GPT-6 Astra puede mejorar otros modelos de IA cambiando sus pesos
En un experimento, Astra elevó la precisión de Qwen3.5-0.8B en MATH-500 del 7,9% al 48,1% cambiando solo el 0,016% de los pesos del modelo.