Thinking Machines publie le transformeur en boucle Inkling 2 Mini
Thinking Machines, la startup fondée par Mira Murati, a publié Inkling 2 Mini, un modèle reposant sur l’architecture looped transformer. Il s’agit de la même approche qui, selon des spéculations, pourrait être à la base de GPT-6 Astra.
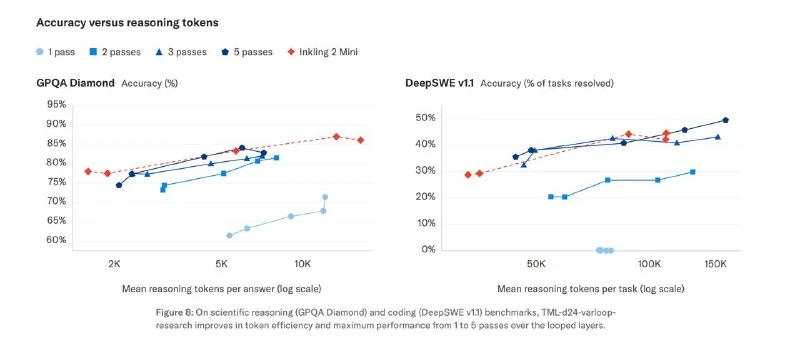
L’idée principale est simple : au lieu de faire passer un état caché par une pile fixe de couches différentes exactement une fois, le modèle traverse plusieurs fois le même bloc de couches avant de générer le token suivant. Cela ajoute de la profondeur au raisonnement sans augmenter le nombre de paramètres ni dépenser de tokens supplémentaires pour raisonner.
Beaucoup supposent que cette architecture pourrait aussi avoir inspiré Fable 5.2 et GPT Sol. La mise en boucle des couches pourrait aider à expliquer la baisse récente des coûts des modèles et l’amélioration de l’efficacité de consommation des tokens observée ces derniers mois.
Thinking Machines a publié une version compacte de looped transformer conçue pour une exécution locale :
- 26,4B de paramètres au total ;
- environ 3,4B de paramètres actifs ;
- environ 5,4B d’activations de poids par token grâce aux passages répétés des couches.
Le modèle contient 24 couches, organisées en quatre blocs de six. Le premier et le dernier bloc sont exécutés une fois, tandis que les deux blocs intermédiaires sont exécutés trois fois chacun. Au total, chaque token nécessite 48 applications de couches. Seules les couches intermédiaires sont répétées, car, selon les auteurs, elles assurent un raisonnement plus abstrait. Lors des tests, cette approche a donné des résultats nettement meilleurs que la mise en boucle des 12 dernières couches.
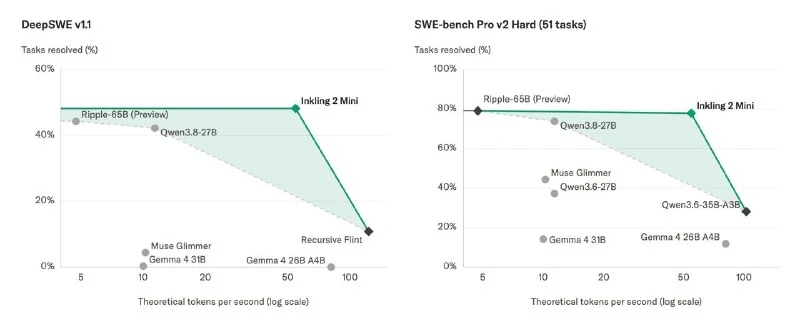
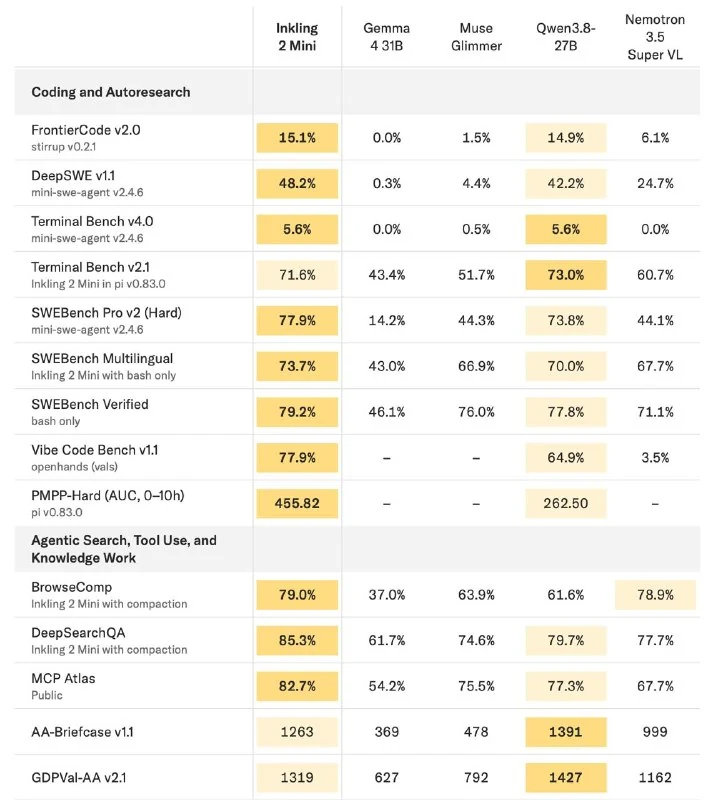
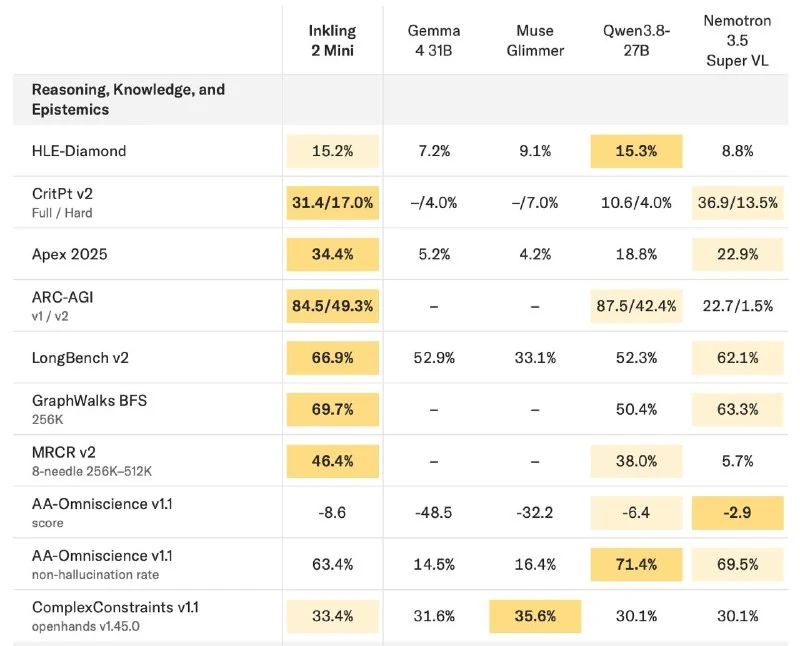
Sur les benchmarks, le modèle affiche un niveau comparable à Qwen3.8-27B, et parfois supérieur sur certaines métriques, malgré un nombre de paramètres inférieur. Pour un déploiement local, c’est une option réellement intéressante.
Pourquoi c'est important
AnalyseInkling 2 Mini montre que les transformeurs en boucle peuvent approfondir le raisonnement sans augmenter proportionnellement la taille du modèle. C’est important pour l’IA locale et edge, où la mémoire et la puissance de calcul sont limitées.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Thinking Machines publie Inkling 2 Mini, un modèle à poids ouverts pour le codage local
Thinking Machines a publié Inkling 2 Mini, un modèle à poids ouverts à l’architecture transformer cyclique, capable de fonctionner localement sur Mac et de coder sans connexion internet.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.
Partie II. Architecture des agents IA : du modèle à la mémoire et aux outils
Immersion technique approfondie : tokenisation, cache KV, déterminisme de l'échantillonnage, stack d'entraînement, quantification, ingénierie contextuelle, stack de sécurité, RAG en production, ReAct et systèmes swarm multi-agents.
Modèles de pointe (Frontier Models)
La classe d'intelligence artificielle la plus puissante à l'avant-garde de la recherche mondiale (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), définissant les limites actuelles des capacités de raisonnement, d'autonomie et de codage.