Thinking Machines veröffentlicht geloopten Transformer Inkling 2 Mini
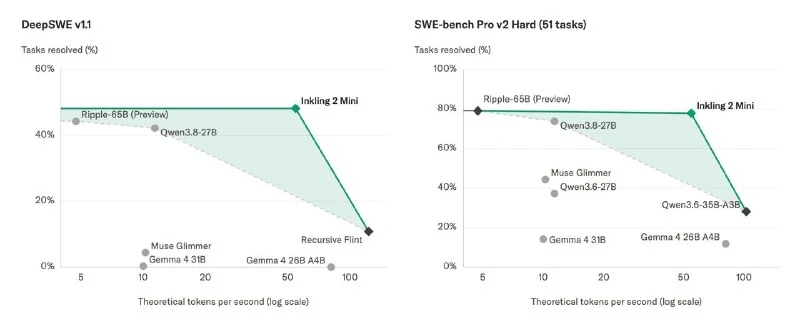
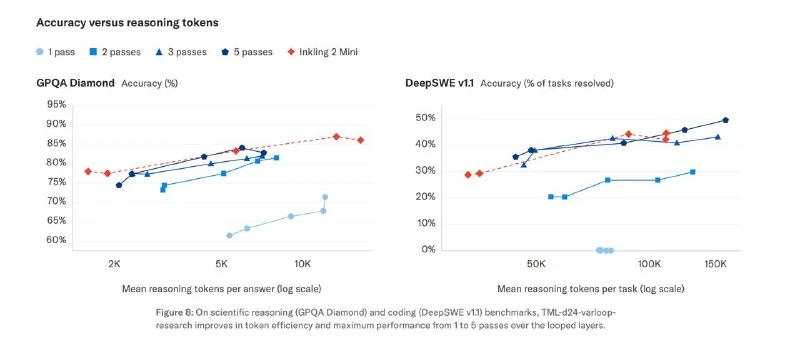
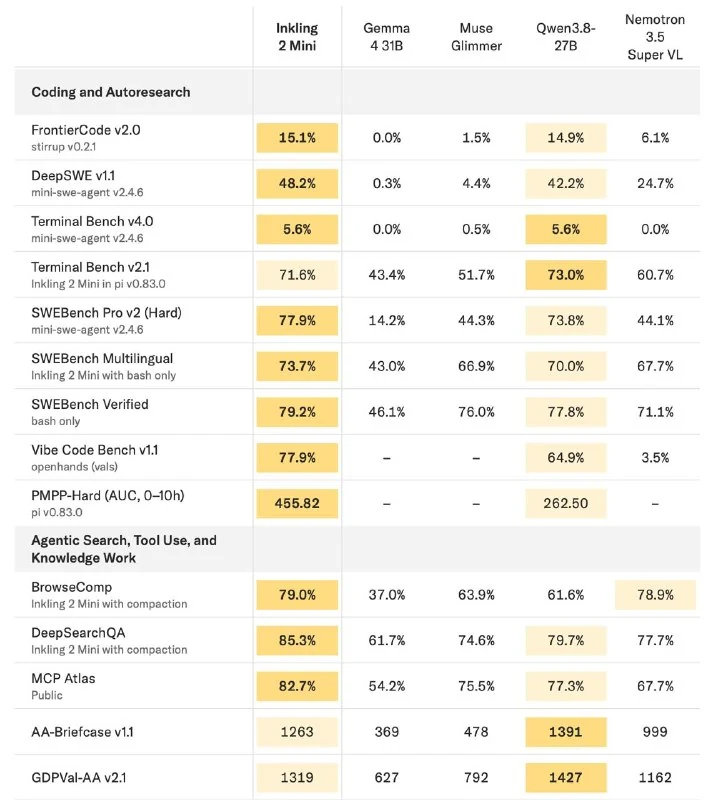
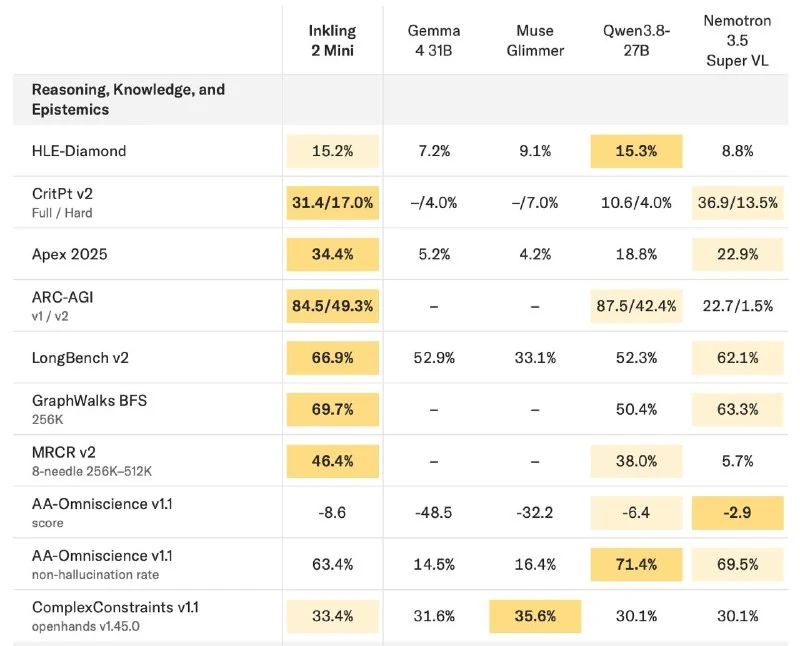
Thinking Machines, das Startup von Mira Murati, hat Inkling 2 Mini veröffentlicht – ein Modell auf Basis der looped-transformer-Architektur. Dieser Ansatz soll nach Spekulationen auch der GPT-6-Astra-Architektur zugrunde liegen.
Die Kernidee: Anstatt einen festen Stapel unterschiedlicher Schichten genau einmal durchlaufen zu lassen, führt das Modell den versteckten Zustand mehrfach durch denselben Schichtenblock, bevor es das nächste Token erzeugt. Das erhöht die Tiefe des Reasonings, ohne die Anzahl der Parameter zu vergrößern oder zusätzliche Tokens für Reasoning zu verbrauchen.
Viele vermuten, dass diese Architektur auch Fable 5.2 und GPT Sol beeinflusst haben könnte. Das Wiederholen von Schichten könnte erklären, warum Modelle in den vergangenen Monaten günstiger wurden und Token effizienter nutzten.
Thinking Machines hat eine kompakte looped-transformer-Version für lokale Inferenz veröffentlicht:
- insgesamt 26,4B Parameter;
- etwa 3,4B aktive Parameter;
- rund 5,4B Gewichtsaktivierungen pro Token durch wiederholte Schichtenläufe.
Das Modell umfasst 24 Schichten, gegliedert in vier Blöcke mit jeweils sechs Schichten. Der erste und letzte Block laufen einmal, die beiden mittleren Blöcke jeweils dreimal. Pro Token ergibt sich dadurch 48 Schichtenanwendungen. Nur die mittleren Schichten werden wiederholt, weil dort laut den Autoren abstrakteres Reasoning stattfindet. In Tests brachte das deutlich bessere Ergebnisse als das Loopen der letzten 12 Schichten.
In Benchmarks erreicht das Modell ein Niveau, das mit Qwen3.8-27B vergleichbar ist, und liegt bei einzelnen Metriken sogar darüber – trotz weniger Parametern. Für lokale Bereitstellung ist es eine wirklich interessante Option.
Warum das wichtig ist
AnalyseInkling 2 Mini zeigt, dass geloopte Transformer die Reasoning-Tiefe erhöhen können, ohne proportional größer zu werden. Das ist wichtig für lokale und Edge-KI, wo Speicher und Rechenleistung begrenzt sind.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Thinking Machines veröffentlicht Inkling 2 Mini: ein Open-Weights-Modell für lokale Programmierung
Thinking Machines hat Inkling 2 Mini mit offenen Gewichten und zyklischer Transformer-Architektur veröffentlicht; das Modell lässt sich lokal auf einem Mac nutzen und konnte offline einen Flugsimulator erstellen.
OpenAI veröffentlicht GPT 6.2 Astra und Sol
OpenAI hat GPT 6.2 Astra und Sol vorgestellt; Astra führt Agenten-Benchmarks an und bietet wettbewerbsfähigere Preise.
Teil I. Architektur von KI-Agenten: Grundlegende Bausteine
Zehn grundlegende Bausteine eines modernen Agenten: Modell-Taxonomie, Runtime-Loop, Prompting-Techniken, Distillation, Skills, Memory, Function Calling und Unit Economics.
Teil II. Architektur von KI-Agenten: Vom Modell zu Gedächtnis und Tools
Tiefes technisches Eintauchen: Tokenisierung, KV-Cache, Determinismus beim Sampling, Trainings-Stack, Quantisierung, Kontext-Engineering, Security-Stack, produktives RAG, ReAct sowie Multi-Agenten-Swarm-Systeme.