Tencent lance Hy4 Flash, un concurrent de Claude Haiku avec contexte d'un million de tokens
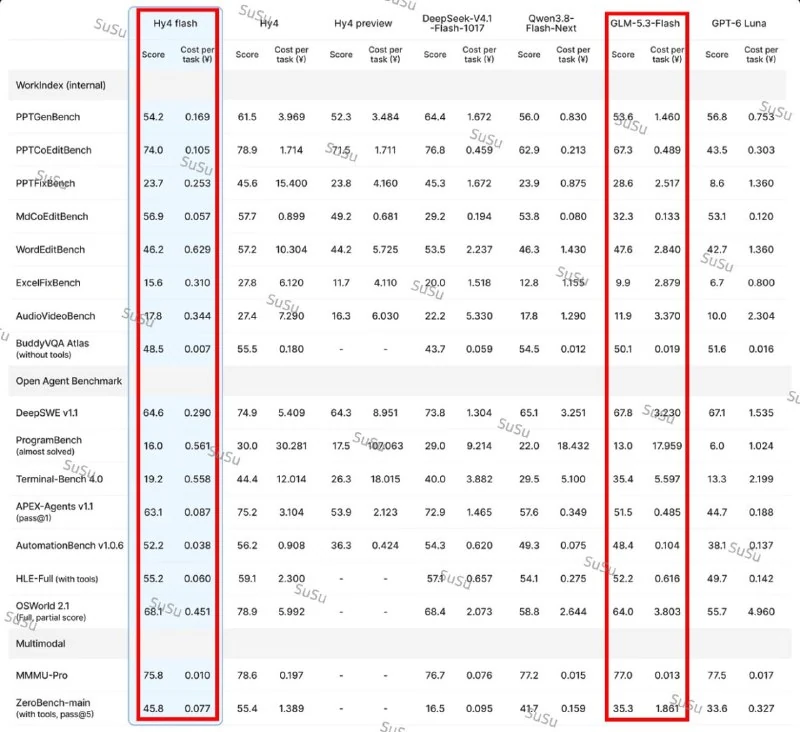
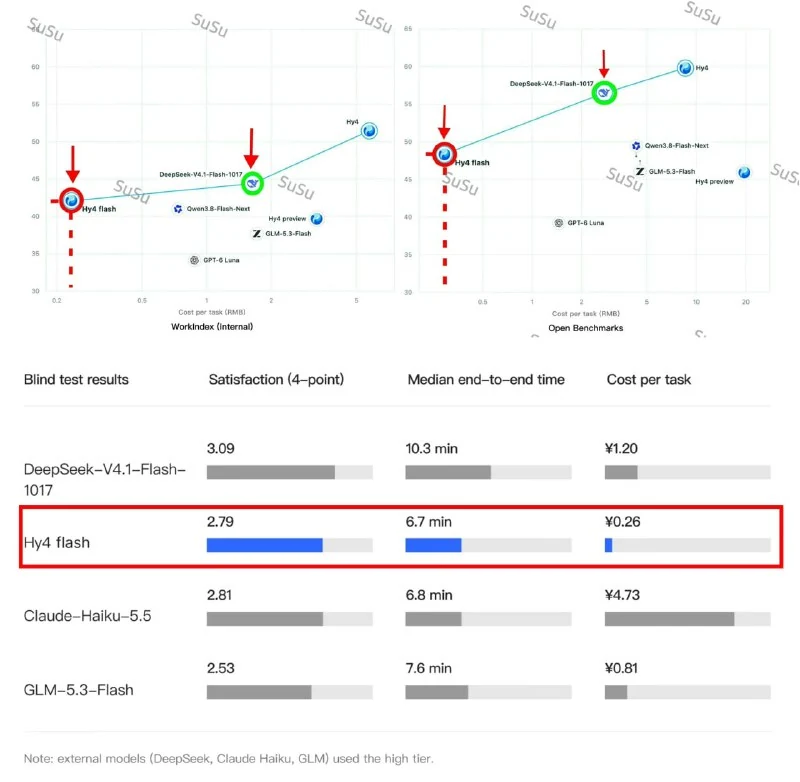
Tencent a publié Hy4 Flash, un modèle multimodal natif avec une fenêtre de contexte d'un million de tokens et des coûts d'inférence bas. L'entreprise affirme qu'il est comparable à Claude Haiku 5.5 en mode High pour les tâches courantes.
Tencent a lancé Hy4 Flash, un modèle multimodal natif présenté comme un concurrent de Claude Haiku.
- 224 milliards de paramètres, dont seulement 12 milliards sont actifs.
- Fenêtre de contexte : un million de tokens.
- Multimodalité native.
- Tarifs : 0,07 $ par million de tokens d'entrée et 0,281 $ par million de tokens de sortie.
- Tokens d'entrée en cache : 0,003 $ par million.
- Selon Tencent, le modèle est comparable à Claude Haiku 5.5 en mode High pour les tâches courantes.
- Le coût d'exécution des tâches est 18 fois plus bas.
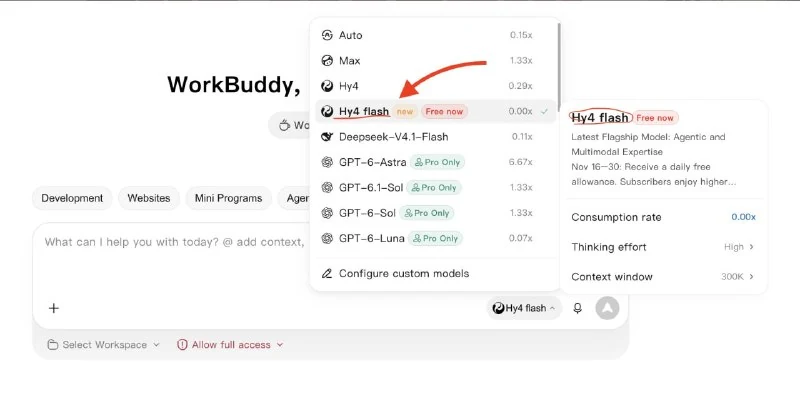
Jusqu'au 30 novembre, le modèle peut également être utilisé gratuitement dans WorkBuddy.
Pourquoi c'est important
AnalyseHy4 Flash montre comment les paramètres actifs clairsemés et la mise en cache peuvent réduire le coût de l'IA pour les tâches routinières tout en conservant un très grand contexte. Pour les développeurs, cela pourrait signifier des assistants, des agents et des applications multimodaux moins chers.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Gemini Flash & Pro (Google Gemini)
La famille de modèles multimodaux de Google DeepMind, qui combine une fenêtre contextuelle record (jusqu'à 2 millions de tokens), une vitesse de génération extrême (plus de 150 tokens/s) et une perception native de la vidéo et de l'audio.
Google Gemini Pro (Modèle Google à contexte illimité)
Le modèle de travail principal de Google DeepMind, doté d'une fenêtre de contexte record de plus de 2 millions de tokens. Il est capable d'analyser en une seule requête des livres entiers, des vidéos chronométrées et des bases de code massives.
Qwen4-Max est disponible : 50 % moins de tokens et un coût par tâche réduit
Qwen4-Max introduit une architecture MoE, une fenêtre de contexte d’un million de tokens et une prise en charge intégrée des images.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.