Tencent lança Hy4 Flash, concorrente do Claude Haiku com contexto de 1 milhão de tokens
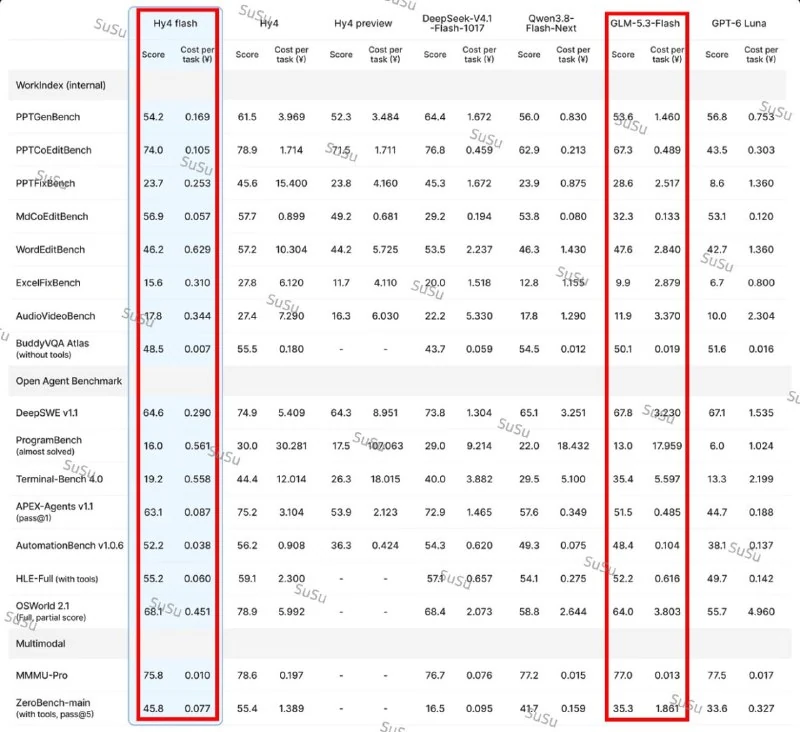
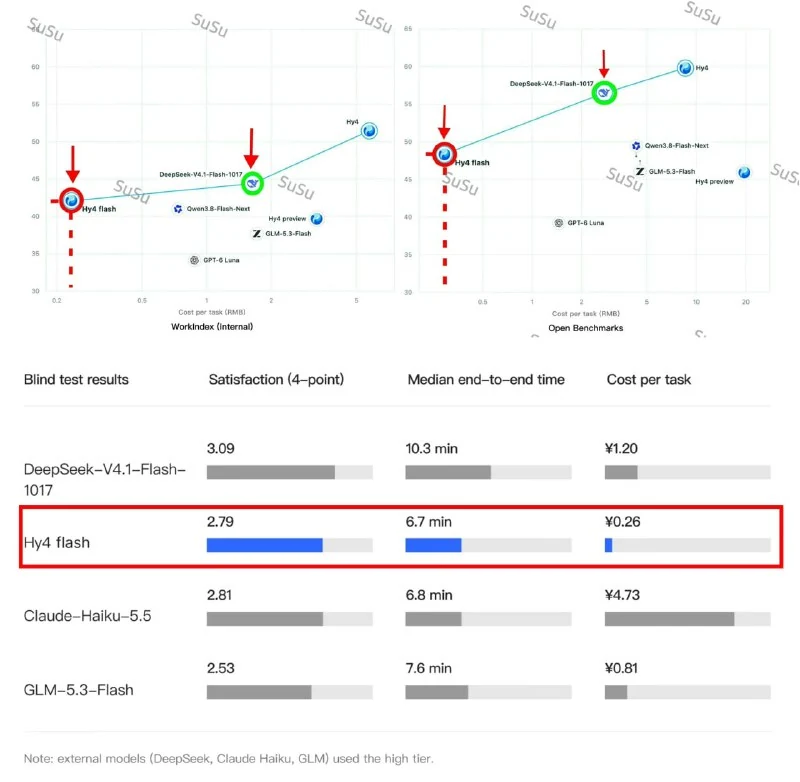
A Tencent lançou o Hy4 Flash, um modelo multimodal nativo com janela de contexto de 1 milhão de tokens e baixo custo de inferência. A empresa afirma que ele é comparável ao Claude Haiku 5.5 no modo High para tarefas do dia a dia.
A Tencent lançou Hy4 Flash, um modelo multimodal nativo posicionado como concorrente do Claude Haiku.
- 224 bilhões de parâmetros, dos quais apenas 12 bilhões estão ativos.
- Janela de contexto: 1 milhão de tokens.
- Multimodalidade nativa.
- Preços: US$ 0,07 por milhão de tokens de entrada e US$ 0,281 por milhão de tokens de saída.
- Tokens de entrada em cache: US$ 0,003 por milhão.
- Segundo a Tencent, o modelo é comparável ao Claude Haiku 5.5 no modo High para tarefas do dia a dia.
- O custo de execução de tarefas é 18 vezes menor.
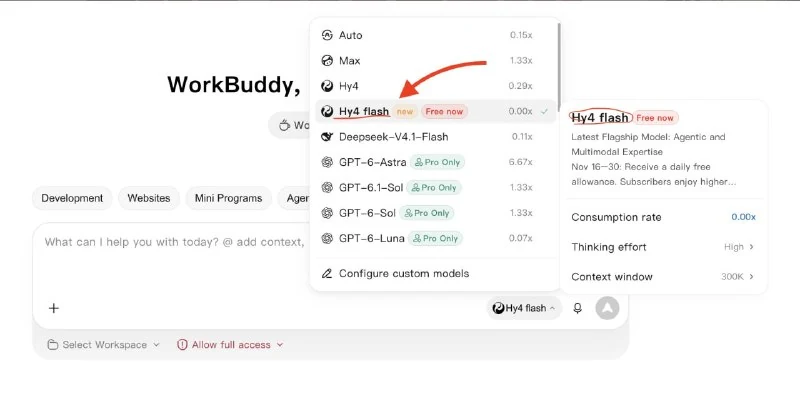
Até 30 de novembro, o modelo também pode ser usado gratuitamente no WorkBuddy.
Por que isso importa
AnáliseO Hy4 Flash mostra como parâmetros ativos esparsos e cache podem reduzir o custo da IA para cargas de trabalho rotineiras sem abrir mão de um contexto muito grande. Para desenvolvedores, isso pode significar assistentes, agentes e aplicações multimodais mais baratos.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Gemini Flash & Pro (Google Gemini)
Família de modelos multimodais da Google DeepMind, que combina uma janela de contexto recorde (até 2 milhões de tokens), velocidade extrema de geração (mais de 150 tokens/s) e percepção nativa de vídeo e áudio.
Google Gemini Pro (Modelo Google com Contexto Ilimitado)
Modelo de trabalho principal da Google DeepMind, com uma janela de contexto recorde de mais de 2 milhões de tokens. Capaz de analisar livros inteiros, vídeos longos e bases de código massivas em uma única solicitação.
Qwen-4 Max é lançado oficialmente: modelo para agentes e tarefas de longo prazo
O Qwen-4 Max é posicionado como modelo para tarefas agênticas e de longo prazo, com menor uso de tokens e custo reduzido em comparação ao Qwen-3.8.
Qwen4-Max já está disponível: 50% menos tokens e custo menor por tarefa
Qwen4-Max chega com arquitetura MoE, contexto de 1 milhão de tokens, suporte integrado a imagens e redução significativa de custos.