Recurrent Looped Transformer: Ein neuer Architekturansatz für KI
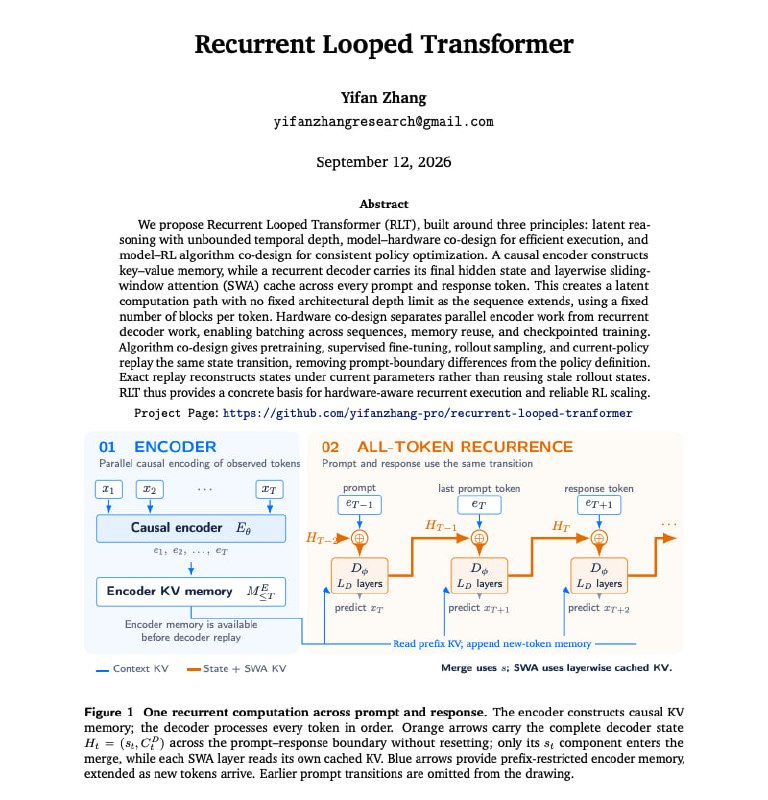
Ein neues technisches Bericht schlägt vor, die Schleife zwischen den Tokens zu erweitern und den Decoder pro Token rekursiv zu gestalten, um die rechnerische Tiefe zu erhöhen, ohne die Kosten pro Token zu steigern.
Der Looped Transformer ist derzeit eine der meistdiskutierten Architekturideen im Bereich der künstlichen Intelligenz.
In einem neuen technischen Bericht wird vorgeschlagen, den bereits bestehenden Zyklus zwischen den Tokens auszuweiten. Der Recurrent Looped Transformer macht den Decoder für jedes einzelne Token rekursiv und deckt dabei sowohl den Prompt als auch die Antwort ab.
Der kausale Encoder bildet ein gemeinsames KV-Gedächtnis (Key-Value Memory). Für jedes neue Token kombiniert der Decoder:
- Die Repräsentation dieses Tokens aus dem Encoder.
- Seinen eigenen letzten versteckten Zustand (Hidden State) vom vorherigen Token.
- Einen Cache mit kürzlichen Aktivierungen unter Verwendung eines gleitenden Fensters (Sliding Window).
Bei einem Decoder mit 48 Schichten führt der Berechnungspfad nach t Tokens durch 48t Decoder-Blöcke, obwohl jedes individuelle Token weiterhin nur eine feste Anzahl von Blöcken durchläuft.
Das bedeutet, dass die Tiefe der Berechnung mit der Sequenzlänge wächst, während die Kosten für die Verarbeitung eines einzelnen Tokens konstant bleiben.
Derselbe Zustandsübergang wird für das Pre-Training, SFT (Supervised Fine-Tuning), die Generierung und das Replay in RL (Reinforcement Learning) verwendet. Der Zustand wird an der Grenze zwischen Prompt und Antwort nicht zurückgesetzt.
Beim RL-Replay werden die Zustände mit den aktuellen Modellgewichten neu aufgebaut, anstatt veraltete Zustände aus früheren Läufen wiederzuverwenden.
Bisher handelt es sich jedoch rein um einen Architekturvorschlag. Der Autor weist ausdrücklich darauf hin, dass Verbesserungen beim Reasoning, bei der Hardware-Beschleunigung und beim Skalieren von RL Ziele sind, die noch nicht gemessen wurden.
Warum das wichtig ist
AnalyseDieser Ansatz bietet eine Möglichkeit, die effektive Tiefe neuronaler Netze dynamisch basierend auf der Sequenzlänge zu skalieren, was potenziell die Reasoning-Fähigkeiten des Modells verbessert, ohne die Inferenzkosten linear zu erhöhen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Einführung in Hugging Face und Transformer: Vom Start bis zur Architektur
Ein Schritt-für-Schritt-Leitfaden für alle, die verstehen möchten, wie moderne Sprachmodelle (BERT, GPT und andere) funktionieren, wie sie ausgeführt, genutzt und an eigene Aufgaben angepasst werden können – anhand der Transformers-Bibliothek und der Hugging-Face-Plattform.
Transformer-Architektur
Eine von Google-Forschern im Jahr 2017 in der Arbeit „Attention Is All You Need“ vorgestellte neuronalen Netzwerkarchitektur. Sie bildet die Grundlage aller modernen Sprachmodelle (GPT, Claude, Gemini, Llama), ersetzte langsame rekurrente Netzwerke und ermöglichte die parallele Verarbeitung des gesamten Textes gleichzeitig.
Eigenes Design-System in Claude Design erstellen: Vom Moodboard zum animierten Markenmaskottchen
Praxisleitfaden für Claude Design: Visuelle Referenzen kuratieren, 4 kontrastierende Designkonzepte generieren, Design-Tokens definieren, Stresstests durchführen und SVG-Maskottchen animieren.
Agent-to-Agent Protocol (A2A)
Ein offener Standard für Netzwerkinteraktion, dezentrale Entdeckung und sicheren Kontextaustausch zwischen unabhängigen KI-Agenten verschiedener Anbieter und Plattformen.