Recurrent Looped Transformer: Una nueva idea arquitectónica para la IA
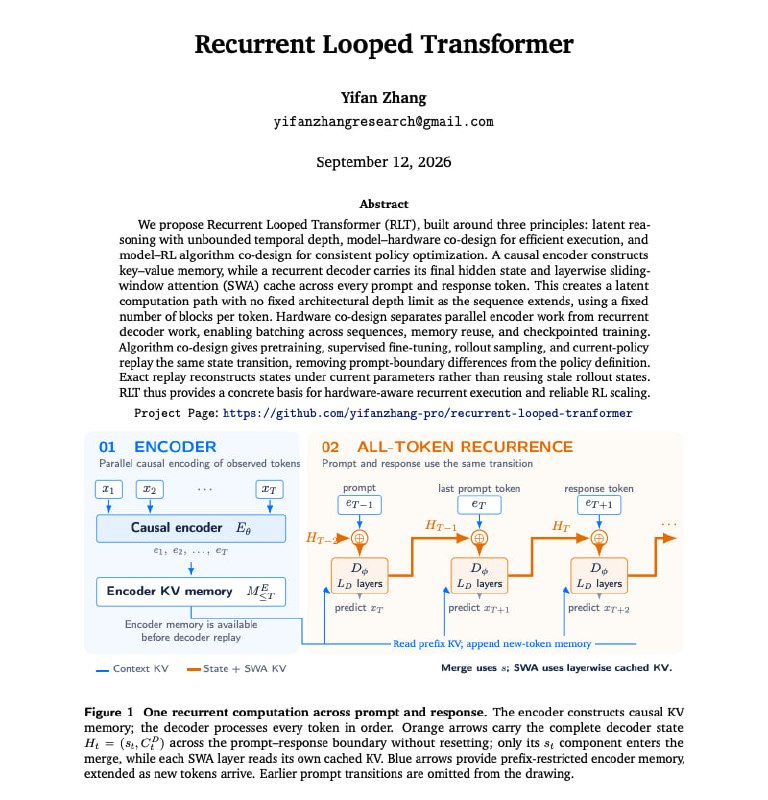
Un nuevo informe técnico propone extender el bucle entre los tokens, haciendo que el decodificador sea recurrente para cada token para aumentar la profundidad computacional sin aumentar el costo por token.
Looped Transformer es actualmente una de las ideas arquitectónicas más debatidas en el campo de la inteligencia artificial.
En un nuevo informe técnico, se propone extender el ciclo ya entre los tokens. El Recurrent Looped Transformer hace que el decodificador sea recurrente para cada token, cubriendo tanto la solicitud como la respuesta.
El codificador causal forma una memoria KV compartida. Para cada nuevo token, el decodificador combina:
- La representación de este token del codificador.
- Su propio estado oculto final del token anterior.
- Una caché de activaciones recientes con una ventana deslizante.
Con un decodificador de 48 capas, la ruta de cálculo después de t tokens pasa a través de 48t bloques de decodificación, aunque cada token individual aún realiza un número fijo de bloques.
Esto significa que la profundidad del cálculo crece con la longitud de la secuencia, mientras que el costo de procesar un solo token permanece constante.
La misma transición de estado se utiliza para el preentrenamiento, SFT, generación y reproducción en RL. El estado no se restablece en el límite entre la solicitud y la respuesta.
Durante la reproducción de RL, los estados se reconstruyen con los pesos actuales del modelo en lugar de reutilizar estados obsoletos de ejecuciones anteriores.
Por ahora, esta es puramente una propuesta arquitectónica. El autor indica explícitamente que las mejoras en el razonamiento, la aceleración de hardware y el escalado de RL son objetivos que aún no se han medido.
Por qué es importante
AnálisisEste enfoque ofrece una forma de escalar la profundidad efectiva de las redes neuronales dinámicamente según la longitud de la secuencia, mejorando potencialmente las capacidades de razonamiento sin aumentar linealmente los costos de inferencia.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
50 estilos de diseño visual: guía fundamental para sistemas de diseño, UI/UX y dirección de arte
Un diccionario visual completo de 50 estilos de diseño: análisis estético, paletas de color, combinaciones tipográficas, reglas para sistemas de diseño y control preciso de IA.
Claude + Excel para logística: 10 escenarios listos para auditar tarifas, OTD y costos
Playbook B2B práctico sobre la integración de Claude y Excel: prompts de sistema listos para usar, fórmulas y algoritmos para analizar variaciones de flete, OTD, proveedores e inventarios.
Benchmarks para Agentes: GAIA y SWE-bench
Nueva generación de rigurosos benchmarks prácticos para evaluar la autonomía de la inteligencia artificial. GAIA prueba tareas multimodales en la web abierta con archivos y navegador, mientras que SWE-bench evalúa la capacidad de los agentes para encontrar y corregir errores reales en grandes repositorios de GitHub.
Monte Carlo Tree Search para Agentes (MCTS)
Enfoque algorítmico para la planificación de acciones de agentes de IA que combina búsqueda heurística, evaluación de estados intermedios y retroceso para encontrar soluciones óptimas en espacios de alta complejidad.