Recurrent Looped Transformer : Une nouvelle approche architecturale pour l'IA
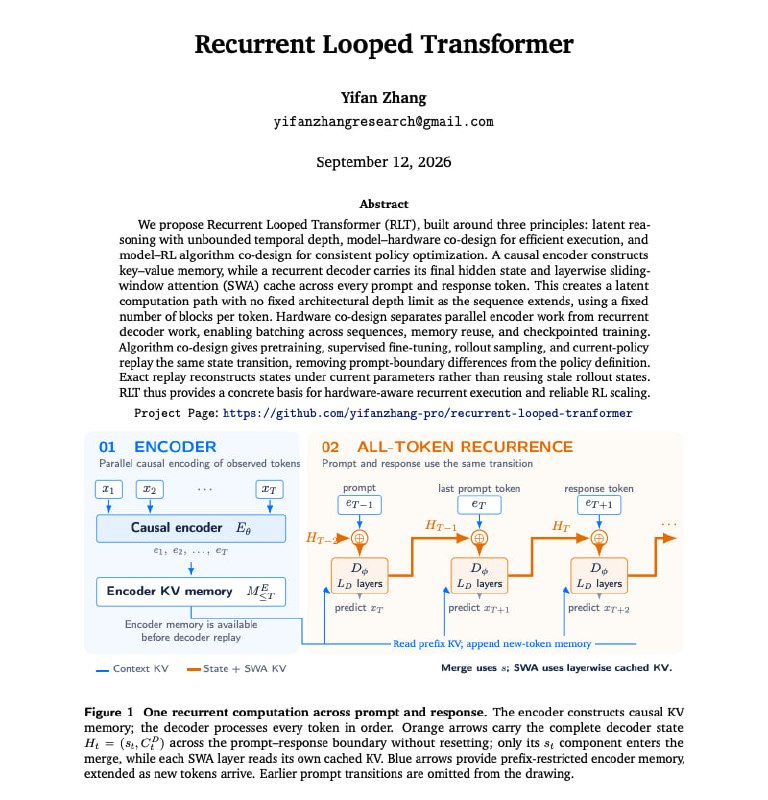
Un nouveau rapport technique propose d'étendre la boucle entre les tokens, rendant le décodeur récurrent pour chaque token afin d'augmenter la profondeur de calcul sans accroître le coût par token.
Le Looped Transformer est actuellement l'une des idées architecturales les plus discutées dans le domaine de l'intelligence artificielle.
Dans un nouveau rapport technique, la proposition consiste à étendre le cycle déjà existant entre les tokens. Le Recurrent Looped Transformer rend le décodeur récurrent pour chaque token, couvrant à la fois le prompt et la réponse.
L'encodeur causal forme une mémoire KV partagée. Pour chaque nouveau token, le décodeur combine :
- La représentation de ce token issue de l'encodeur.
- Son propre état caché final du token précédent.
- Un cache des activations récentes avec une fenêtre glissante.
Avec un décodeur de 48 couches, le chemin de calcul après t tokens traverse 48t blocs de décodeur, bien que chaque token individuel effectue toujours un nombre fixe de blocs.
Cela signifie que la profondeur de calcul augmente avec la longueur de la séquence, tandis que le coût de traitement d'un seul token reste constant.
La même transition d'état est utilisée pour le pré-entraînement, le SFT (Supervised Fine-Tuning), la génération et le replay en RL (Reinforcement Learning). L'état n'est pas réinitialisé à la frontière entre le prompt et la réponse.
Lors du replay en RL, les états sont reconstruits avec les poids actuels du modèle au lieu de réutiliser des états obsolètes issus des exécutions précédentes.
Pour l'instant, il s'agit purement d'une proposition architecturale. L'auteur précise explicitement que les améliorations en matière de raisonnement, d'accélération matérielle et de mise à l'échelle du RL sont des objectifs qui n'ont pas encore été mesurés.
Pourquoi c'est important
AnalyseCette approche offre un moyen de faire évoluer dynamiquement la profondeur effective des réseaux de neurones selon la longueur de la séquence, améliorant potentiellement les capacités de raisonnement des modèles sans augmenter linéairement les coûts d'inférence.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs