Recurrent Looped Transformer: Uma Nova Abordagem Arquitetural para IA
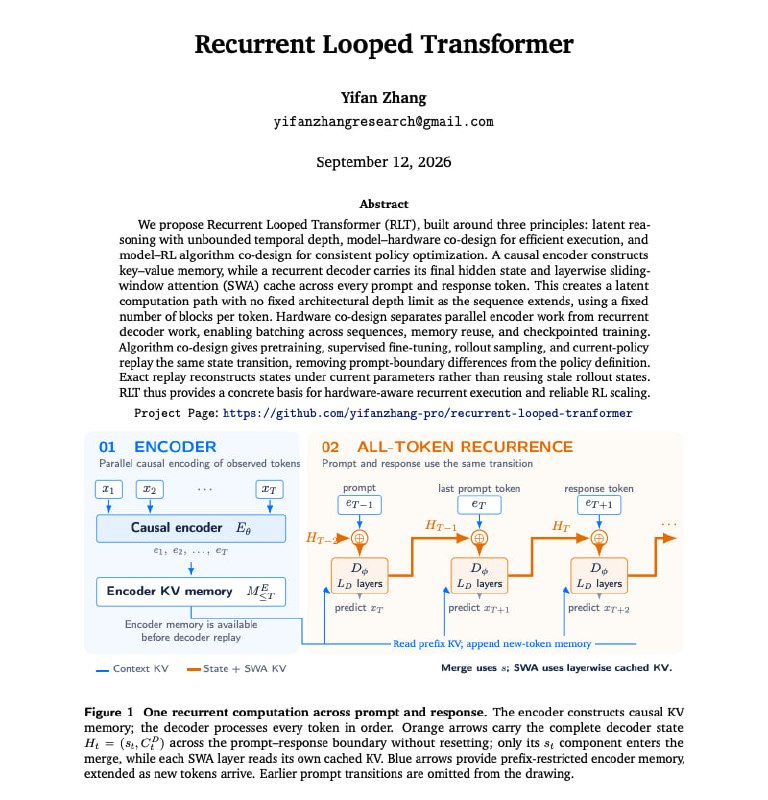
Um novo relatório técnico propõe estender o ciclo entre tokens, tornando o decodificador recorrente para cada token, aumentando a profundidade computacional sem elevar o custo por token.
O Looped Transformer é atualmente uma das ideias arquitetônicas mais debatidas no campo da inteligência artificial.
Em um novo relatório técnico, a proposta consiste em alongar o ciclo já existente entre os tokens. O Recurrent Looped Transformer torna o decodificador recorrente para cada token individual, abrangendo tanto o prompt quanto a resposta gerada.
O codificador causal forma uma memória KV compartilhada. Para cada novo token, o decodificador combina:
- A representação deste token proveniente do codificador.
- Seu próprio estado oculto final do token anterior.
- Um cache de ativações recentes com janela deslizante.
Com um decodificador de 48 camadas, o caminho de computação após t tokens passa por 48t blocos de decodificação, embora cada token individual ainda execute um número fixo de blocos.
Isso significa que a profundidade da computação cresce com o comprimento da sequência, enquanto o custo de processamento de um único token permanece constante.
A mesma transição de estado é utilizada para pré-treinamento, SFT (Fine-Tuning Supervisionado), geração e replay em RL (Aprendizado por Reforço). O estado não é reiniciado na fronteira entre o prompt e a resposta.
Durante o replay de RL, os estados são reconstruídos com os pesos atuais do modelo, em vez de reutilizar estados desatualizados de execuções anteriores.
Por enquanto, esta é puramente uma proposta arquitetônica. O autor declara explicitamente que melhorias em raciocínio, aceleração de hardware e escalabilidade de RL são objetivos que ainda não foram medidos.
Por que isso importa
AnáliseEsta abordagem oferece uma maneira de escalar dinamicamente a profundidade efetiva das redes neurais com base no comprimento da sequência, potencialmente aprimorando as capacidades de raciocínio dos modelos sem aumentar linearmente os custos de inferência.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores