Qwen4-Max est disponible : 50 % moins de tokens et un coût par tâche réduit
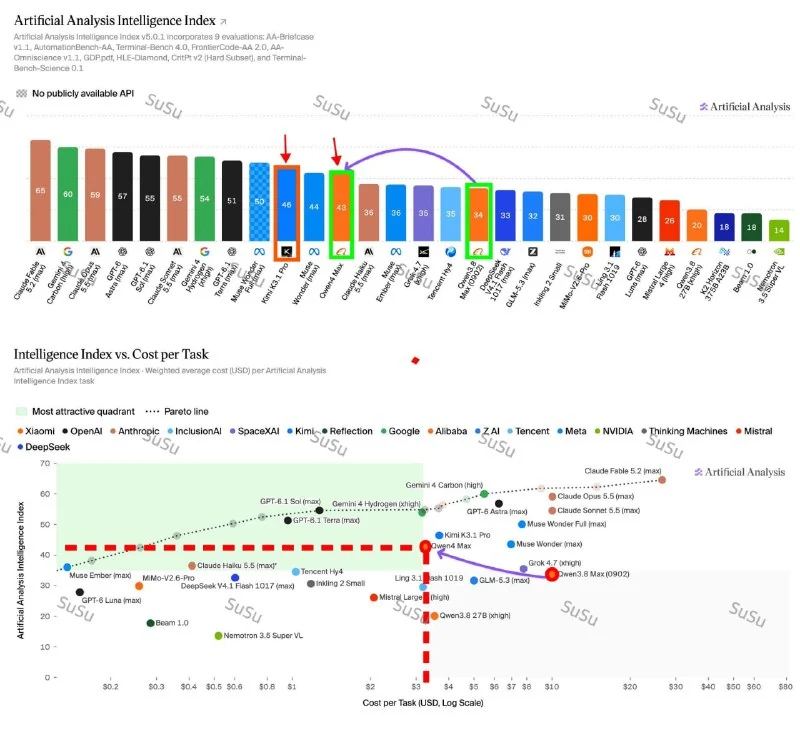
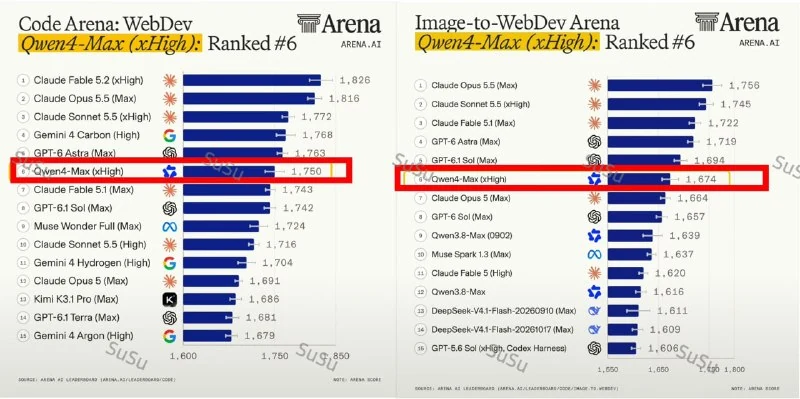
Qwen4-Max introduit une architecture MoE, une fenêtre de contexte d’un million de tokens et une prise en charge intégrée des images.
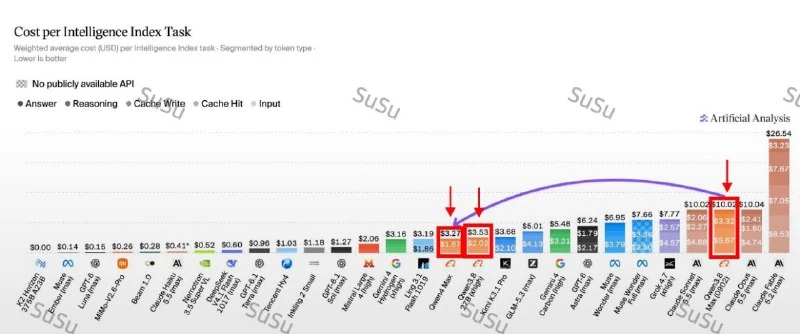
Qwen4-Max est désormais disponible. Selon l’annonce, le modèle utilise 50 % moins de tokens et coûte plus de 60 % moins cher par tâche accomplie.
Principales caractéristiques :
- Utilisation réduite de 50 % des tokens.
- Coût par tâche inférieur de plus de 60 %.
- Architecture MoE (Mixture-of-Experts).
- Fenêtre de contexte d’un million de tokens.
- Prise en charge intégrée des images.
Qwen4-Max est conçue non seulement pour la programmation, mais aussi pour des tâches pratiques : modélisation 3D, production, finance, droit, médecine et recherche scientifique.
L’API est déjà disponible via la page officielle de Qwen4-Max. Les poids ouverts de Qwen4-27B sont prévus plus tard.
Pourquoi c'est important
AnalyseC’est utile pour les équipes qui cherchent des modèles multimodaux plus économiques pour des contextes longs.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Qwen-4 Max est officiellement présenté : modèle pour agents et tâches de long horizon
Qwen-4 Max est positionné comme un modèle pour les tâches agentiques et de long horizon, avec une utilisation moindre de tokens et un coût réduit par rapport à Qwen-3.8.
Tencent lance Hy4 Flash, un concurrent de Claude Haiku avec contexte d'un million de tokens
Tencent a publié Hy4 Flash, un modèle multimodal natif avec une fenêtre de contexte d'un million de tokens et des coûts d'inférence bas. L'entreprise affirme qu'il est comparable à Claude Haiku 5.5 en mode High pour les tâches courantes.
Guide complet de Higgsfield Cinema Studio 4.0 : gestion des scènes, Soul 2.0 et automatisation via API
Analyse pratique détaillée de la mise à jour majeure de Higgsfield : Cinema Studio 4.0, personnages cohérents avec Soul 2.0, génération via API et pipeline UGC prêt à l'emploi.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.