Qwen4-Max veröffentlicht: 50 % weniger Tokens und niedrigere Kosten pro Aufgabe
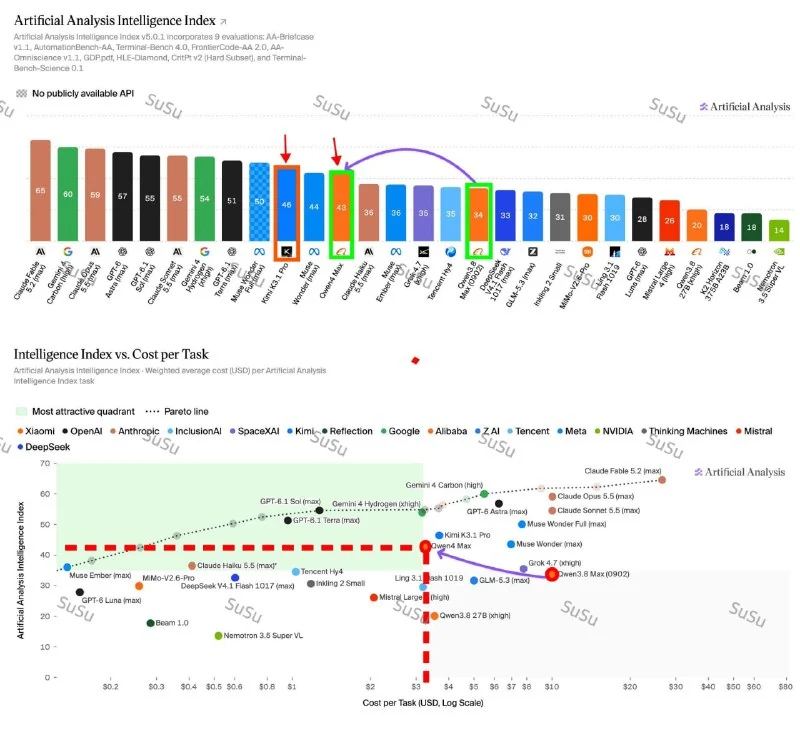
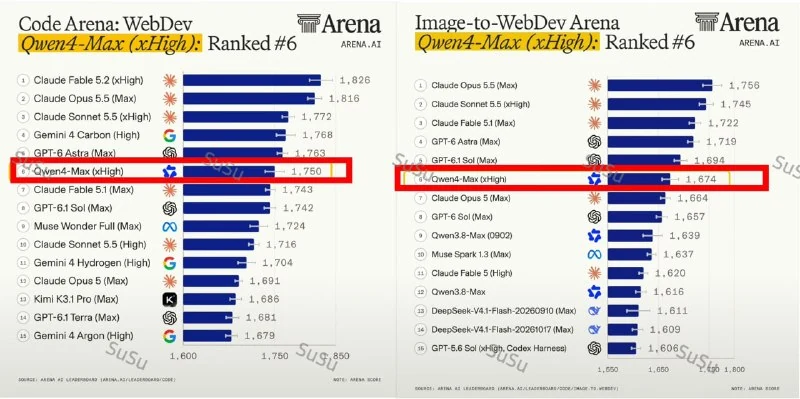
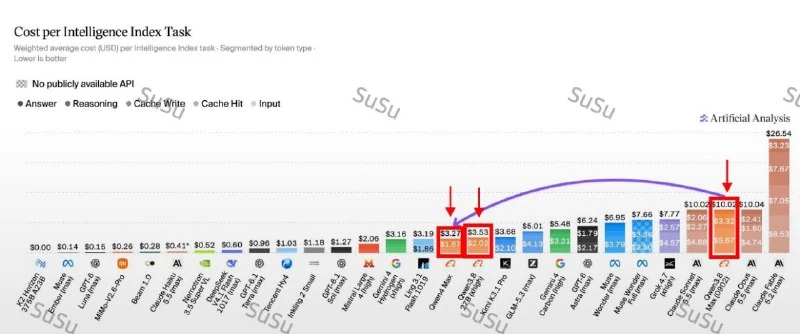
Qwen4-Max bringt eine MoE-Architektur, ein 1-Million-Tokens-Kontextfenster, integrierte Bildunterstützung und deutlich geringere Kosten.
Qwen4-Max ist jetzt verfügbar. Laut Ankündigung nutzt das Modell 50 % weniger Tokens und ist mehr als 60 % günstiger pro abgeschlossener Aufgabe.
Wichtigste Funktionen:
- 50 % geringerer Token-Verbrauch.
- Mehr als 60 % niedrigere Kosten pro Aufgabe.
- Mixture-of-Experts-Architektur (MoE).
- Kontextfenster mit 1 Million Tokens.
- Integrierte Unterstützung für Bilder.
Qwen4-Max ist nicht nur für Programmierung gedacht, sondern auch für praktische Aufgaben: 3D-Modellierung, Fertigung, Finanzen, Recht, Medizin und wissenschaftliche Forschung.
Die API ist bereits über die offizielle Qwen4-Max-Seite verfügbar. Offene Gewichte für Qwen4-27B sollen später erscheinen.
Warum das wichtig ist
AnalyseDas Modell könnte die Kosten für lange Kontexte und multimodale KI-Workflows senken.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Qwen-4 Max offiziell vorgestellt: Modell für Agenten und langfristige Aufgaben
Qwen-4 Max wird als Modell für agentische und langfristige Aufgaben positioniert, mit geringerem Tokenverbrauch und niedrigeren Kosten gegenüber Qwen-3.8.
Tencent veröffentlicht Hy4 Flash: Claude-Haiku-Konkurrent mit 1-Million-Tokens-Kontext
Tencent hat Hy4 Flash vorgestellt, ein natives multimodales Modell mit 1 Million Tokens Kontextfenster und niedrigen Inferenzkosten. Laut Tencent ist es für Alltagsaufgaben mit Claude Haiku 5.5 im High-Modus vergleichbar.
Vollständiger Leitfaden zu Higgsfield Cinema Studio 4.0: Szenensteuerung, Soul 2.0 und API-Automatisierung
Detaillierte praktische Analyse des großen Updates von Higgsfield: Cinema Studio 4.0, konsistente Charaktere mit Soul 2.0, Generierung über die API und ein fertiger UGC-Workflow.
Teil I. Architektur von KI-Agenten: Grundlegende Bausteine
Zehn grundlegende Bausteine eines modernen Agenten: Modell-Taxonomie, Runtime-Loop, Prompting-Techniken, Distillation, Skills, Memory, Function Calling und Unit Economics.