Qwen udostępnia Qwen-Image-2.1: potężny otwarty model do generowania i edycji obrazów
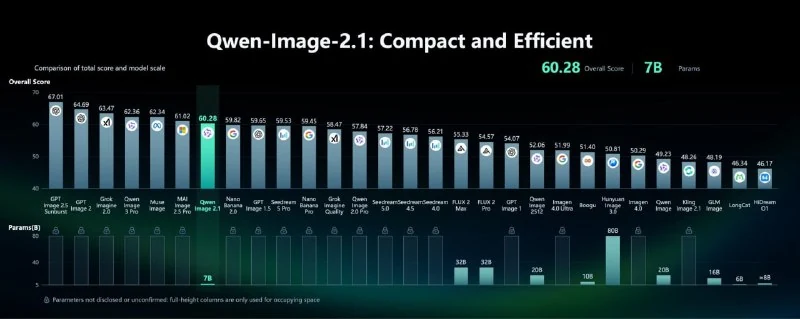
Firma Qwen zaprezentowała Qwen-Image-2.1, otwarty model o 7 miliardach parametrów, który przewyższa Nano Banana 2.0 w zakresie generowania i edycji grafik.
Qwen wypuścił kolejną znaczącą aktualizację. Przedstawiamy Qwen-Image-2.1 – otwarty model z 7 miliardami parametrów przeznaczony do generowania i edycji obrazów, który wykazuje lepsze wyniki niż Nano Banana 2.0.
Model obsługuje do 10 obrazów referencyjnych, lokalną edycję oraz natywne wsparcie dla przezroczystości. Dzięki temu użytkownicy mogą od razu generować grafiki z przezroczystym tłem i wycinać obiekty bez konieczności stosowania osobnej maski.
Dostęp do modelu jest możliwy na platformie Hugging Face: Qwen/Qwen-Image-2.1
Dodatkowo społeczność już stworzyła wersję bez cenzury: Qwen-Image-2.1-Uncensored-GGUF
Dlaczego to ważne
AnalizaTo wydanie oferuje solidną alternatywę open-source dla generowania obrazów, wprowadzając zaawansowane funkcje, takie jak natywne wsparcie przezroczystości, które usprawniają procesy twórcze.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Na Hugging Face pojawił się niemal całkowicie bezcenzuralny model Qwen3.5-9B
Model DeepSeek-V4-Pro-Qwen3.5-9B-UNCENSORED został dostrojony i zmodyfikowany tak, aby znacznie rzadziej odmawiał; wersja Q4 waży około 5,6 GB.
GPT Image / DALL-E (Generowanie obrazów w ChatGPT)
Wbudowane narzędzie do generowania treści wizualnych bezpośrednio w oknie czatu z ChatGPT. Umożliwia tworzenie ilustracji, concept artu, napisów na plakatowych oraz lokalną edycję fragmentów obrazów.
Jev i System One AI: Kompletny praktyczny przewodnik po modelu decyzyjnym od TypeSafe
Głęboka analiza inżynieryjna flagowego modelu Jev: architektura System One w kontraście do LLM, prymitywy Choice/Score/Noul, równoległość zapytań, matematyka pewności, przypadki użycia wideo, kod oraz przegląd lokalnych alternatyw open-weight (Laya, GLiNER2.5, CLM-8B).
Modele dyfuzyjne (Diffusion Models)
Architektura modeli generatywnych (Stable Diffusion, Midjourney, FLUX) oparta na zasadach termodynamiki nierównowagowej. Działa w dwóch etapach: dyfuzja prosta (stopniowe niszczenie zdjęcia przez losowy szum) oraz dyfuzja odwrotna (etapowe oczyszczanie szumu do krystalicznie czystego obrazu na podstawie opisu tekstowego).