PrismML lance Bonsai 2 27B : un modèle IA local de 5,9 Go basé sur Qwen
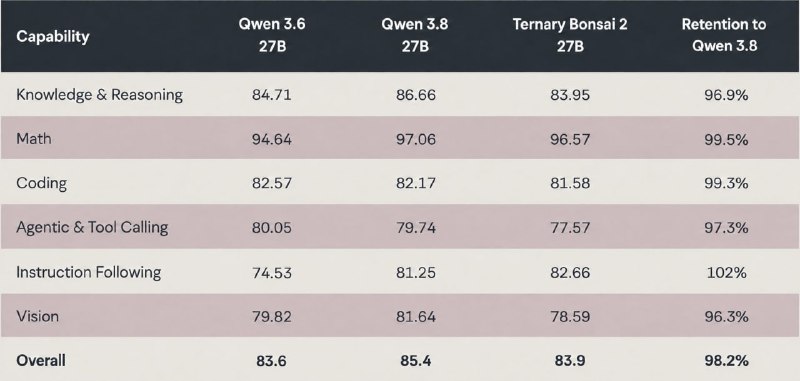
PrismML a dévoilé Bonsai 2 27B, un modèle quantifié issu de l'architecture Qwen qui ne pèse que 5,9 Go tout en conservant 98,2 % des performances originales.
L'équipe PrismML a présenté le nouveau modèle Bonsai 2 27B, construit sur l'architecture Qwen3.8 27B. Cette sortie marque une avancée significative dans le domaine des modèles locaux et de l'optimisation des ressources.
Grâce à une quantification sur 3 bits, la taille du modèle a été réduite à 5,9 Go, soit environ neuf fois moins que la version complète. Cela le rend idéal pour une exécution sur des appareils disposant d'une mémoire limitée.
Selon les tests des développeurs, le modèle conserve 98,2 % des résultats du modèle original. Parallèlement, il prend en charge le traitement d'images (multimodalité) et l'appel d'outils (function calling).
Le modèle Bonsai 2 27B est ouvert et disponible sous licence Apache 2.0. L'annonce officielle peut être consultée sur le site web de PrismML.
Pourquoi c'est important
AnalyseCette innovation est cruciale pour les développeurs souhaitant déployer des modèles d'IA puissants localement sans matériel coûteux, tout en maintenant une haute précision et des fonctionnalités avancées.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Des chercheurs du MIT montrent qu'un LLM peut lire et modifier les poids d'un modèle sans entraînement
MIT CSAIL a présenté Weight-Space Programming : Astra a lu et modifié les poids de Qwen3.5-0.8B sans descente de gradient ni fine-tuning, améliorant ses scores sur MATH-500 et GSM8K.
GPT-6 Astra aurait modifié les poids d'un autre modèle d'IA sans réentraînement
GPT-6 Astra aurait modifié 0,016 % des poids de Qwen3.5-0.8B sans gradients ni réentraînement, améliorant le raisonnement, les résultats mathématiques et le suivi des instructions.
AWQ & Activation-Aware GPU Quantization
Méthodes de compression des poids à 4 bits pour les modèles de langage, optimisées pour l'architecture des Tensor Cores NVIDIA afin de maximiser le débit et préserver les canaux d'activation critiques.
GGUF & Modern Quantization Standards
Universal binary file format for storing and instantly loading quantized language models on CPUs and GPUs in llama.cpp, Ollama, and LM Studio.