GLM 5.3 vorgestellt: Fortschritte in der Cybersicherheit durch skalierbares Reinforcement Learning
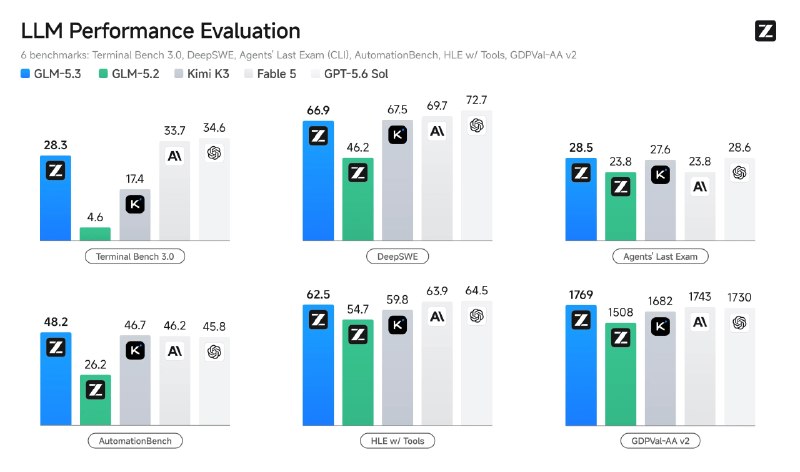
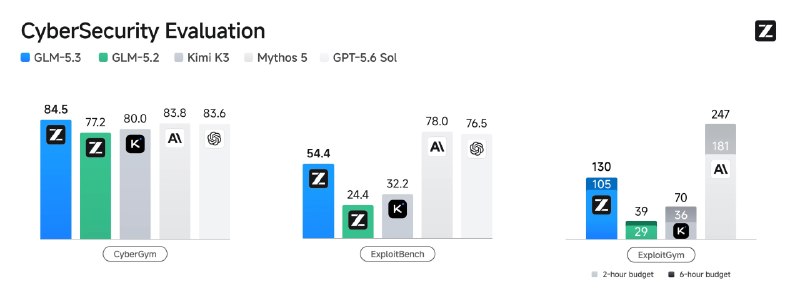
Das neue Modell GLM 5.3 erzielt signifikante Verbesserungen in der Cybersicherheit und hat seit der Vorgängerversion bereits 2.500 Schwachstellen identifiziert. Diese Leistung basiert auf einer optimierten Skalierung des Reinforcement Learnings für reale Aufgaben.
Vorstellung von GLM 5.3
Die Leistungssteigerung gegenüber Version 5.2 wurde ausschließlich durch die Skalierung des Reinforcement Learnings (RL) erreicht, mit einem besonderen Fokus auf RL-Anwendungen für reale Aufgaben, wie etwa die Optimierung des Modelltrainings. Dieser Ansatz führte zu einem plötzlichen und erheblichen Anstieg der Fähigkeiten im Bereich der Cybersicherheit. Das Unternehmen gibt an, dass seine Modelle seit der Veröffentlichung von GLM 5.2 insgesamt 2.500 Sicherheitslücken entdeckt haben – darunter eine Schwachstelle, die bereits 45 Jahre alt ist.
Die Gewichte des Modells sind derzeit noch nicht verfügbar; ihre Veröffentlichung wird jedoch innerhalb der nächsten zwei Wochen erwartet.
Warum das wichtig ist
AnalyseGLM 5.3 demonstriert einen bedeutenden Fortschritt bei der automatisierten Erkennung von Sicherheitslücken, was die technologische Sicherheit grundlegend stärken kann. Die erfolgreiche Anwendung von Reinforcement Learning auf komplexe, reale Trainingsaufgaben eröffnet zudem neue Wege zur Effizienzsteigerung in der Entwicklung großer Sprachmodelle.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
MIT-Forschende zeigen, dass GPT-6 Astra andere KI-Modelle durch direkte Gewichtsänderungen verbessern kann
In einem Experiment erhöhte Astra die Genauigkeit von Qwen3.5-0.8B auf MATH-500 von 7,9 % auf 48,1 %, indem nur 0,016 % der Modellgewichte geändert wurden.
JSON – strukturierte Daten für Anwendungen, APIs und KI-Agenten
Ein umfassender praktischer Leitfaden zum JSON-Format: Syntaxregeln, Serialisierung über parse/stringify, Arbeit mit REST-APIs, JSON Schema und strukturierter Output für künstliche Intelligenz.
DOCX- und XLSX-Formate: Wann ein vollwertiges finales Dokument von KI erforderlich ist
Ein umfassender praktischer Leitfaden zur Generierung und Verarbeitung von DOCX-Dokumenten und XLSX-Tabellen mit KI: Vergleich mit Markdown und CSV, Prompt-Engineering, Arbeit mit Formeln und Automatisierung im Code.
Prompt-Inversion (Reverse Engineering von Prompts)
Eine Sicherheitsangriffsmethode für KI-Anwendungen (Prompt Extraction / Prompt Inversion), die darauf abzielt, versteckte System-Prompts, kommerzielle Logik oder private Unternehmensanweisungen durch speziell formulierte Dialog-Fallen zu extrahieren.