Premiera GLM 5.3: Przełom w cyberbezpieczeństwie dzięki skalowaniu RL
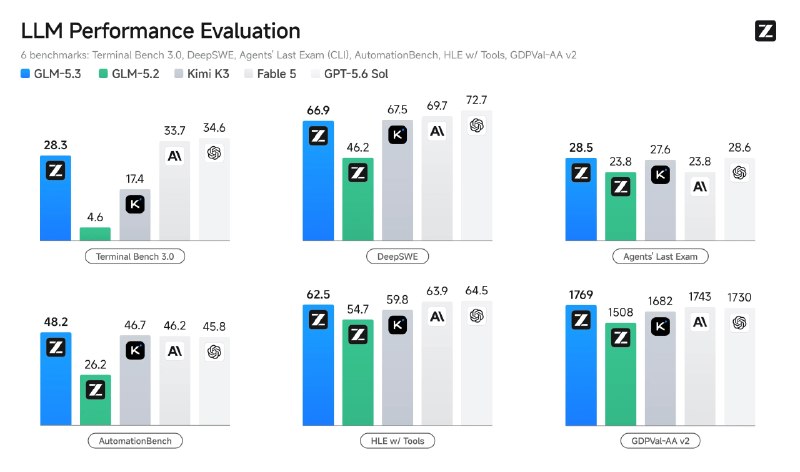
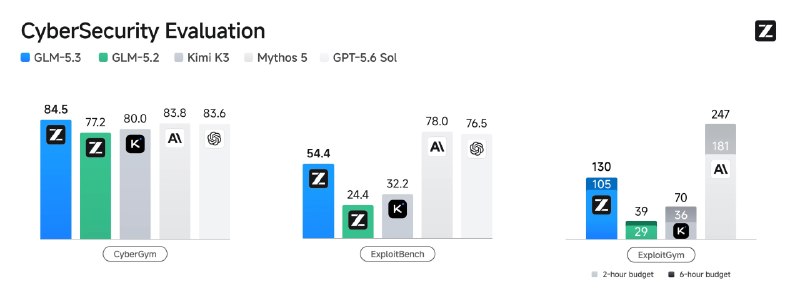
GLM 5.3 wprowadza znaczące ulepszenia w zakresie cyberbezpieczeństwa, wykrywając 2500 podatności od czasu poprzedniej wersji. Nowe podejście do trenowania modeli otwiera drogę do istotnych postępów technologicznych.
Przedstawiamy — GLM 5.3
Wzrost wydajności w porównaniu z wersją 5.2 został osiągnięty wyłącznie poprzez skalowanie uczenia przez wzmacnianie (RL), ze szczególnym naciskiem na zastosowanie RL do rzeczywistych zadań, takich jak optymalizacja procesu treningu modelu. Nagłe wdrożenie tego podejścia przyniosło znaczący skok w dziedzinie cyberbezpieczeństwa – firma twierdzi, że ich modele wykryły 2500 podatności bezpieczeństwa od momentu premiery GLM 5.2, przy czym najstarsza zidentyfikowana luka ma aż 45 lat. Wagi modelu nie są obecnie dostępne publicznie, jednak producent obiecuje ich udostępnienie w ciągu dwóch tygodni.
Dlaczego to ważne
AnalizaGLM 5.3 demonstruje znaczący postęp w detekcji podatności, co może fundamentalnie zwiększyć poziom bezpieczeństwa w branży technologicznej. Zastosowanie uczenia przez wzmacnianie do rozwiązywania realnych problemów otwiera nowe możliwości w optymalizacji i trenowaniu zaawansowanych modeli AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
JSON — dane ustrukturyzowane dla aplikacji, API i agentów AI
Kompletny praktyczny przewodnik po formacie JSON: zasady składniowe, serializacja za pomocą parse/stringify, praca z REST API, JSON Schema oraz strukturalne wyjście dla sztucznej inteligencji.
Formaty DOCX i XLSX: kiedy potrzebny jest pełnoprawny dokument końcowy od AI
Kompletny praktyczny przewodnik po generowaniu i przetwarzaniu dokumentów DOCX oraz arkuszy XLSX za pomocą AI: porównanie z Markdown i CSV, inżynieria promptów, praca z formułami oraz automatyzacja w kodzie.
Odwracanie inżynieryjne promptów (Prompt Inversion / Extraction)
Atak na bezpieczeństwo aplikacji AI (Prompt Extraction / Prompt Inversion), którego celem jest wykradzenie ukrytego promptu systemowego, logiki biznesowej lub prywatnych instrukcji firmy poprzez specjalnie sformułowane pułapki dialogowe.
Binance publikuje śledztwo w sprawie kradzieży 6,3 mld USD
Śledztwo wiąże kradzież ze zmodyfikowanym Homebrew, fałszywą rozmową kwalifikacyjną i wykorzystaniem wewnętrznego narzędzia AI Binance.