Нова техніка промптинга від дослідників Стенфорда
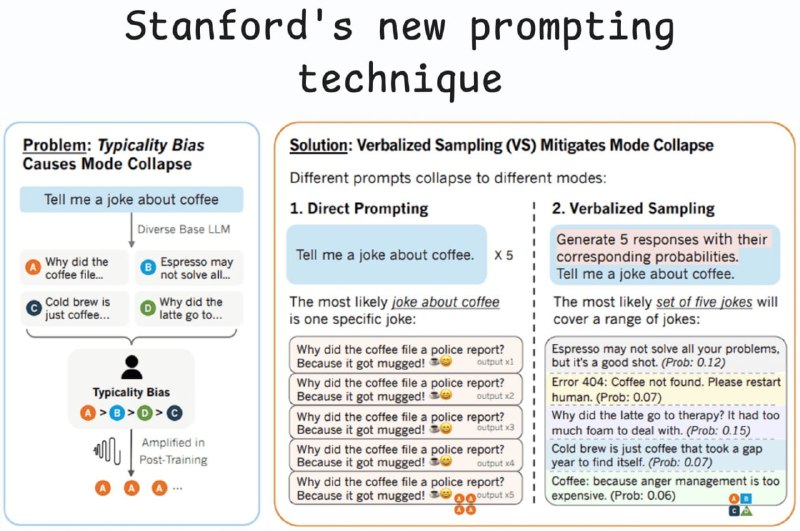
Дослідники з Стенфорда представили нову техніку промптинга, яка підвищує креативність моделей штучного інтелекту. Ця техніка дозволяє уникнути проблеми зниження різноманітності відповідей.
Дослідники з Стенфорда розробили нову техніку промптинга.
Додавання приблизно 20 слів у промпт дозволяє:
- збільшити креативність LLM у 1,6–2 рази;
- підвищити різноманіття відповідей за оцінками людей на 25,7%;
- перевершити дообучену модель без будь-якого додаткового навчання;
- відновити 66,8% креативності LLM, втрачену після alignment.
Методи post-training alignment, такі як RLHF, призначені для того, щоб зробити LLM більш корисними та безпечними. Однак ці методи ненавмисно призводять до суттєвого зниження різноманіття генерованих відповідей (явище, відоме як mode collapse).
Коли у LLM виникає mode collapse, модель починає віддавати перевагу вузькому набору передбачуваних або шаблонних відповідей замість інших можливих варіантів. Це відбувається тому, що дані про людські переваги, які використовуються для навчання LLM, містять прихований недолік, відомий як typicality bias.
Ось як це відбувається: Аннотатори оцінюють різні відповіді LLM, після чого модель навчається з використанням reward model, яка повинна відтворювати ці людські переваги.
Однак аннотатори природно схильні віддавати перевагу більш звичним, легко читабельним і передбачуваним відповідям. Це і є typicality bias.
Тому навіть якщо новий, більш креативний відповідь не поступається за якістю, людина частіше вибирає більш звичний варіант. В результаті reward model починає посилювати відповіді, які початкова модель (до проходження alignment) вже вважала найбільш ймовірними.
Це призводить до надмірного загострення розподілу ймовірностей LLM, через що креативний спектр відповідей моделі стискається до одного або двох домінуючих, найбільш передбачуваних варіантів.
Проте цей ефект не є незворотним, і після alignment в LLM все ще можна умовно виділити дві «особистості»:
- початкову модель, яка під час pre-training засвоїла багатий набір можливих варіантів;
- модель після alignment, орієнтовану на безпеку.
Саме цю проблему вирішує Verbalized Sampling (VS).
Це стратегія промптинга, що не вимагає додаткового навчання моделі, розроблена для обходу mode collapse і відновлення різноманітного розподілу, сформованого під час pre-training.
Ключова ідея Verbalized Sampling полягає в тому, що сам промпт виступає в ролі своєрідного ментального перемикача. Якщо безпосередньо задати запит: «Розкажи жарт», то відразу активується версія моделі після alignment, яка видасть найбільш посилений у процесі навчання відповідь.
Але при використанні Verbalized Sampling промпт виглядає так: «Сгенеруй 5 відповідей з відповідними ймовірностями. Розкажи жарт.»
У цьому випадку промпт запитує не конкретну відповідь, а розподіл. Через це модель після alignment починає описувати все простір своїх знань і змушена використовувати те різноманітне розподіл, яке було сформовано під час pre-training.
Таким чином модель звертається до більш широкого і різноманітного набору ідей, який все ще зберігається в її базових вагах, отриманих на етапі pre-training.
Verbalized Sampling збільшує різноманіття генерації в 1,6–2,1 рази в порівнянні з прямим промптингом, одночасно зберігаючи або підвищуючи якість відповідей.
Такі варіанти, як Verbalized Sampling-based CoT і Verbalized Sampling-based Multi, ще сильніше збільшують різноманіття генерації.
Стаття: arxiv.org
Чому це важливо
АналітикаЦя нова техніка промптинга може значно підвищити креативність моделей штучного інтелекту, що важливо для їхнього використання в різних сферах. Вона дозволяє уникнути проблеми зниження різноманітності відповідей, що є критично важливим для розвитку AI.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 і зміни тарифів OpenAI та Anthropic
Огляд свіжих новин AI: оновлення великих мовних моделей, зміни підписок OpenAI та Anthropic, а також нові world-моделі, відеогенератори й корпоративні фінансові деталі.
Дослідники MIT показали, що GPT-6 Astra може покращувати інші ШІ-моделі, змінюючи їхні ваги
У експерименті Astra підвищила точність Qwen3.5-0.8B на бенчмарку MATH-500 із 7,9% до 48,1%, змінивши лише 0,016% ваг моделі.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.
Частина II. Архітектура ШІ-агентів: від моделі до пам'яті та інструментів
Глибоке інженерне занурення: токенізація, KV-кеш, детермінізм семплінгу, тренувальний стек, квантування, контекстна інженерія, стек безпеки, виробничий RAG, ReAct та мультиагентні swarm-системи.