Des chercheurs du MIT montrent qu'un LLM peut lire et modifier les poids d'un modèle sans entraînement
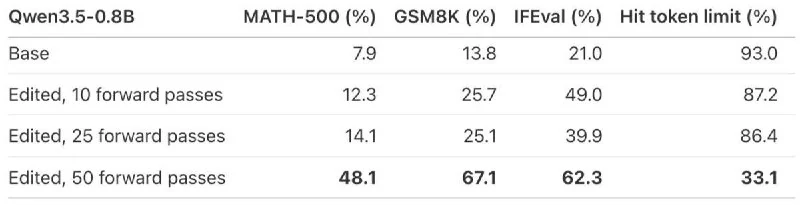
MIT CSAIL a présenté Weight-Space Programming : Astra a lu et modifié les poids de Qwen3.5-0.8B sans descente de gradient ni fine-tuning, améliorant ses scores sur MATH-500 et GSM8K.
Des chercheurs de MIT CSAIL ont présenté Weight-Space Programming : les grands modèles de langage peuvent lire directement et modifier intentionnellement les poids des réseaux de neurones sans descente de gradient ni entraînement.
Dans l'expérience principale, les auteurs ont donné à Astra les poids du petit modèle Qwen3.5-0.8B et lui ont demandé d'améliorer ses capacités mathématiques. Astra a trouvé dans les poids des neurones qui faisaient boucler le modèle dans son raisonnement, et les a corrigés. Elle a réécrit environ 0,016 % des poids, après quoi le score de Qwen3.5-0.8B sur MATH-500 est passé de 7,9 % à 48,1 %, et sur GSM8K de 13,8 % à 67,1 %.
Les chercheurs ont aussi montré qu'Astra peut interpréter des modèles à partir de leurs poids. Par exemple, ils ont fine-tuné quatre modèles identiques pour jouer à différents jeux : Breakout, Pong, Pac-Man et Freeway. Astra a reçu uniquement les poids (environ 17 000 nombres) et une description des entrées, sans noms de jeux, et a deviné ce que chaque modèle avait appris dans les quatre cas.
Dans une autre expérience, trois modèles de diffusion dessinaient un cercle, un carré et un triangle. Astra a identifié chaque forme à partir des poids, en lisant la couche de sortie, sans exécuter les réseaux.
Astra sait aussi écrire des réseaux de neurones de zéro. Sans entraînement, elle a produit les poids de réseaux pour trois jeux MinAtar. Dans les trois cas, elle a surpassé des modèles entraînés par apprentissage par renforcement (PPO) pendant 100 millions de pas.
Les auteurs lui ont aussi demandé d'écrire un réseau pour le jeu de Go. Elle a produit les poids dans un script de 336 lignes et a remporté plus de la moitié des parties contre deux petits réseaux entraînés par PPO. Si on lui donnait la possibilité de tester plusieurs fois son réseau dans un bac à sable, elle battait un réseau PPO de taille comparable entraîné sur 20 millions de parties.
Les résultats restent précoces, mais la direction est très prometteuse. Weight-Space Programming pourrait servir à l'alignement, à l'audit de modèles, à une initialisation peu coûteuse des poids et à l'auto-amélioration récursive. Les auteurs construisent actuellement un benchmark et un harness pour évaluer la capacité des modèles à programmer des poids. Les logs complets des expériences sont disponibles sur GitHub, et la description détaillée se trouve dans le billet du projet.
Pourquoi c'est important
AnalyseC'est important car Weight-Space Programming ouvre une nouvelle façon d'analyser, corriger et créer des modèles sans entraînement conventionnel, ce qui peut accélérer l'audit, la sécurité et l'optimisation des systèmes d'IA.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
GPT-6 Astra aurait modifié les poids d'un autre modèle d'IA sans réentraînement
GPT-6 Astra aurait modifié 0,016 % des poids de Qwen3.5-0.8B sans gradients ni réentraînement, améliorant le raisonnement, les résultats mathématiques et le suivi des instructions.
Des chercheurs du MIT montrent que GPT-6 Astra peut améliorer d’autres modèles d’IA en modifiant leurs poids
Dans une expérience, Astra a porté la précision de Qwen3.5-0.8B sur MATH-500 de 7,9 % à 48,1 % en ne modifiant que 0,016 % des poids du modèle.
Partie II. Architecture des agents IA : du modèle à la mémoire et aux outils
Immersion technique approfondie : tokenisation, cache KV, déterminisme de l'échantillonnage, stack d'entraînement, quantification, ingénierie contextuelle, stack de sécurité, RAG en production, ReAct et systèmes swarm multi-agents.
Modèles de pointe (Frontier Models)
La classe d'intelligence artificielle la plus puissante à l'avant-garde de la recherche mondiale (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), définissant les limites actuelles des capacités de raisonnement, d'autonomie et de codage.