La puce Jalapeño d'OpenAI surpasse Nvidia en inférence
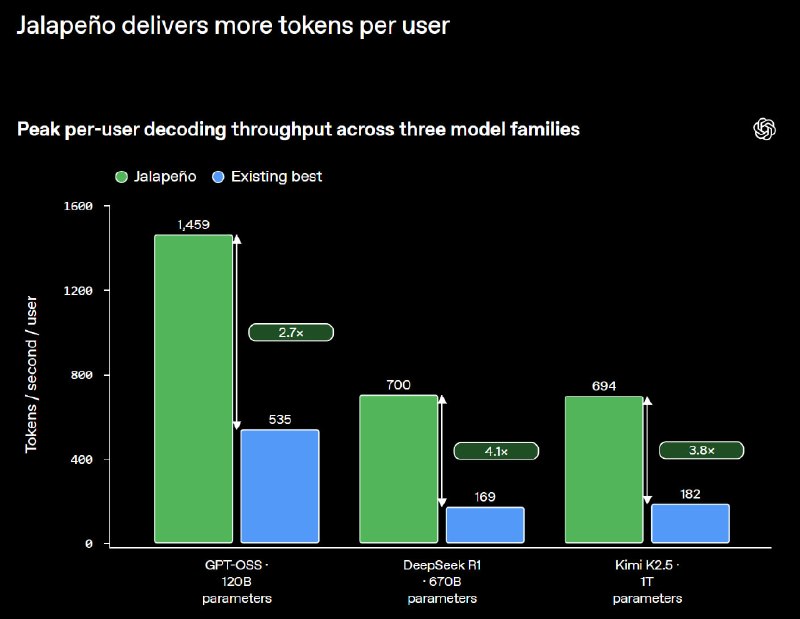
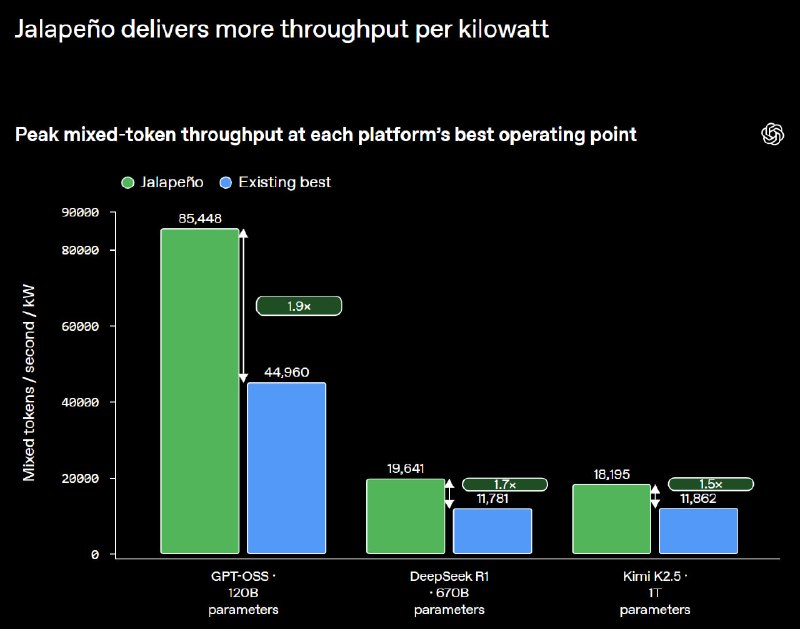
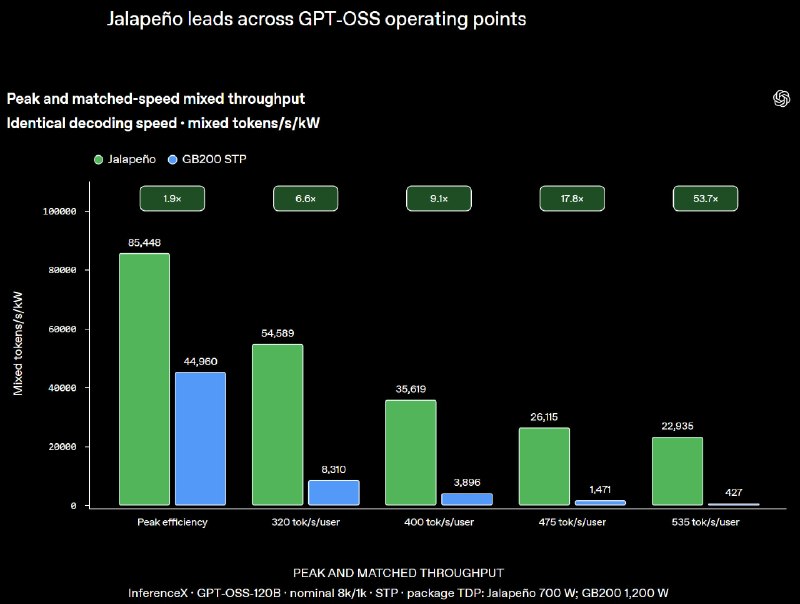
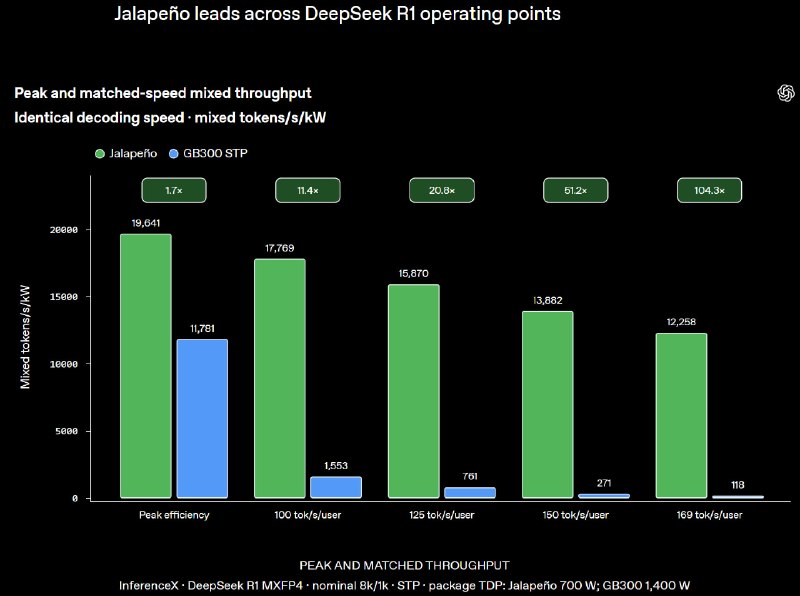
OpenAI a dévoilé sa nouvelle puce Jalapeño, dont les capacités d'inférence dépassent celles des concurrents, y compris Nvidia. Ce développement rapide souligne le potentiel innovant de l'équipe.
La puce Jalapeño d'OpenAI surpasse Nvidia en inférence
OpenAI a publié un article de blog détaillant les tests de la puce Jalapeño sur InferenceX de SemiAnalysis ainsi qu'une présentation lors de la conférence Hot Chips. Chaque puce intègre 216 Go de mémoire HBM4 et peut délivrer jusqu'à 13,4 PFLOP/s en format mxfp4. Comparée aux modèles GB200/GB300, elle génère significativement plus de tokens par seconde à performance maximale et offre jusqu'à deux fois plus de tokens par watt à débit maximal, avec un écart qui s'élargit à mesure que le nombre de tokens par seconde par utilisateur augmente.
Cependant, le véritable concurrent de Jalapeño est la nouvelle génération de puces Nvidia, Rubin. Les résultats de benchmark pour Rubin sont actuellement limités, mais selon les données publiées, Jalapeño semble également surpasser cette dernière. Il est notable que les benchmarks de Rubin utilisent le décodage spéculatif, contrairement à Jalapeño, qui dispose encore d'une grande marge d'optimisation.
En résumé, OpenAI dispose désormais d'une puce très performante rivalisant avec les meilleures solutions Nvidia en matière d'inférence. Le point le plus frappant reste la rapidité du développement : le projet a été lancé en octobre 2024, la première version est entrée en production en novembre 2025, et les premières puces étaient prêtes en mai 2026. En moins de trois mois, le logiciel de la puce atteint déjà un niveau permettant de rivaliser avec les leaders de l'industrie. Fait intéressant, Jalapeño a été développée par une équipe réduite d'environ 30 personnes. Le déploiement à grande échelle de Jalapeño est prévu pour l'année prochaine.
Pourquoi c'est important
AnalyseCette puce pourrait transformer le marché de l'IA en offrant des performances élevées tout en réduisant les coûts énergétiques. Son développement accéléré illustre également la capacité d'innovation fulgurante d'OpenAI.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Quatre conseils de CV du responsable du développement IA appliquée chez OpenAI
Wulfie Bain, responsable du développement IA appliquée chez OpenAI, a partagé quatre règles : brièveté, pertinence, mise en avant des résultats et réalisations clés en premier.
AI Radar : GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 et changements tarifaires d’OpenAI et d’Anthropic
Tour d’horizon des actualités IA : nouveaux modèles LLM, changements d’abonnements OpenAI et Anthropic, modèles de monde, générateurs vidéo et détails d’entreprise.
Le monopole de Nvidia et la plateforme CUDA
Analyse de la domination technologique et économique de Nvidia sur le marché de l'intelligence artificielle. Comment la plateforme logicielle CUDA (Compute Unified Device Architecture), créée en 2006, a transformé les cartes graphiques de jeu ordinaires en l'outil de calcul principal de la planète, et pourquoi il est si difficile pour les concurrents (AMD, Intel) de briser ce monopole.
OpenAI GPT (Modèles phares de la série GPT)
La gamme principale et polyvalente des grands modèles de langage d'OpenAI (GPT-4, GPT-4o). Optimisée pour l'analyse textuelle complexe, la programmation, la création et le travail intellectuel quotidien.