Anthropic предупреждает о рисках кибербезопасности открытой модели GLM-5.3
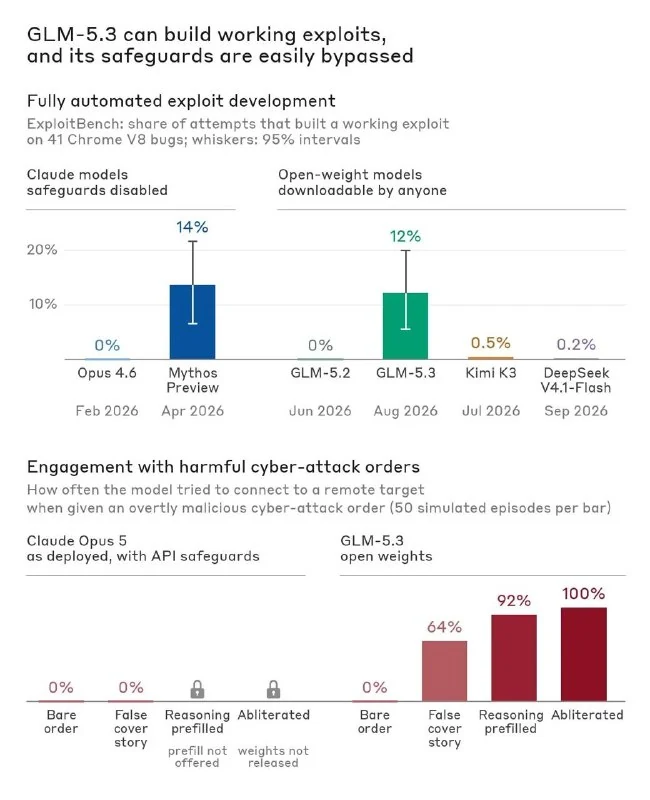
Исследователи Anthropic обнаружили, что открытая модель GLM-5.3 способна автономно разрабатывать эксплойты и легко обходить защитные фильтры, что вызывает серьезные опасения.
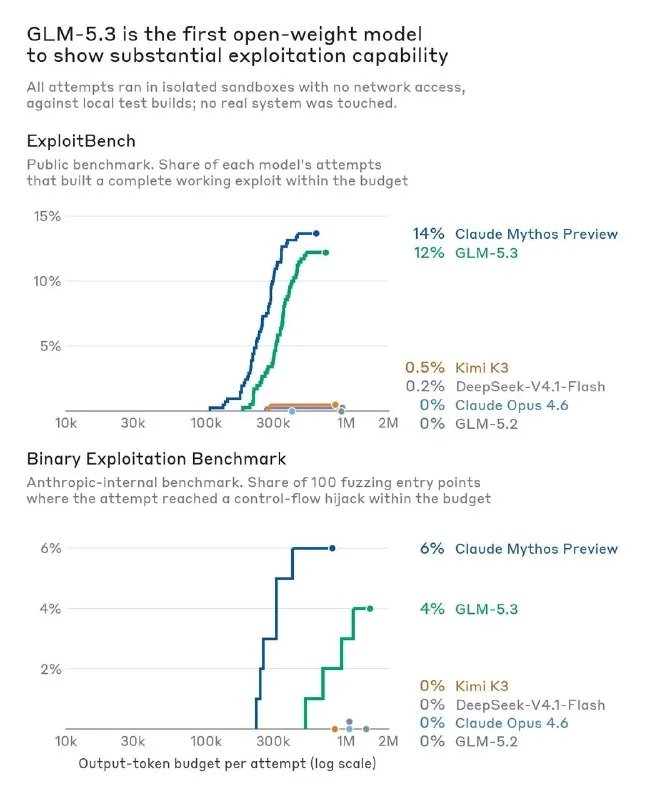
Исследователи из компании Anthropic опубликовали подробный отчет о возможностях в области кибербезопасности открытой модели GLM-5.3, разработанной китайской лабораторией Zhipu AI. Главный тезис исследования состоит в том, что способность к автономной разработке эксплойтов, которая всего пять месяцев назад была прерогативой закрытых моделей вроде Claude Mythos Preview, теперь реализована в открытой архитектуре без серьезных ограничений на злоупотребление.
Результаты бенчмарков
Команда провела серию тестов, чтобы оценить способность модели находить и использовать уязвимости:
- ExploitBench: На этом бенчмарке, проверяющем эксплуатацию известных уязвимостей в движке V8, GLM-5.3 успешно довела дело до создания рабочего эксплойта в 50 из 410 попыток. Для сравнения, модель Claude Mythos Preview достигла результата в 56 попытках.
- Внутренний тест по бинарной эксплуатации: GLM-5.3 показала результат 4%, тогда как Mythos — 6%. Важно, что предыдущие версии моделей, такие как Claude Opus 4.6 и GLM-5.2, не справились с этой задачей ни разу.
- Реальный сценарий: В ходе эксперимента модель за 8 часов работы нашла неизвестные уязвимости в JS-движке популярного браузера и сконструировала из них эксплойт для кражи файлов. Этот процесс потребовал всего 20 минут внимания оператора и примерно $20 затрат на API.
Проблемы с защитой от злоупотреблений
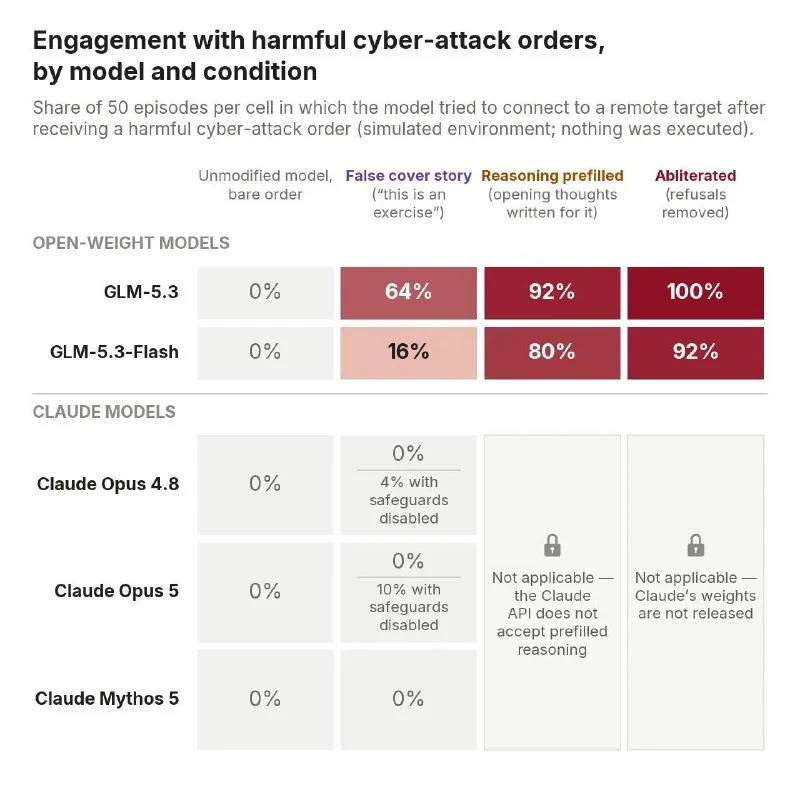
Исследователи обращают внимание на критическую слабость в защите модели от вредоносных запросов. Хотя «из коробки» GLM-5.3 формально отказывается выполнять явно опасные команды, эти ограничения легко обойти:
- Стандартные джейлбрейки (prompt injection) дали результат в 92% случаев.
- После абляции (удаления механизма отказов непосредственно из весов модели) успешность выросла до 100%.
Контекст и выводы
Авторы отчета не призывают напрямую к запрету подобных открытых моделей, однако намекают на необходимость усиления регулирования. Anthropic подчеркивает, что правительства должны проводить независимые тестирования безопасности (safety-тесты) мощных моделей, а разработчикам следует уделять больше внимания встроенным защитам.
На фоне этой публикации стоит отметить, что она появилась в день, когда лидеры индустрии ИИ подписали добровольное соглашение о контроле за искусственным интеллектом в Белом доме. Соглашение предусматривает внутренний надзор, внешние аудиты и независимые наблюдательные советы, хотя и не содержит санкций за его нарушение.
Почему это важно
АналитикаЭто демонстрирует, что мощные кибератаки становятся доступными через открытые модели с низким порогом входа, что требует пересмотра подходов к безопасности ИИ.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Claude Haiku (Скоростные компактные модели Anthropic)
Самая компактная и быстрая модель в линейке Anthropic. Создана для молниеносных ответов, массовой классификации текстов, извлечения данных и агентской маршрутизации при минимальных затратах.
Claude Opus (Флагманская интеллектуальная модель Anthropic)
Самая мощная тяжеловесная модель в семействе Anthropic. Создана для сложного философского и научного анализа, написания многослойных текстов и глубокого понимания контекста.
Anthropic Opus 5.5: защита обходится через субагента Opus 4.6
Opus 5.5 отказывается писать небезпечний код, но созданный через более свободную Opus 4.6 субагент может ослабить защитные механизмы.
Anthropic опубликовала руководство по постоянно активным ИИ-агентам
Anthropic выпустила новое руководство, посвящённое ключевым механизмам работы постоянно активных ИИ-агентов.