Anthropic explora el espacio de pensamiento interno de Claude
Anthropic ha publicado un nuevo estudio que revela el espacio de pensamiento interno del modelo Claude. Este descubrimiento destaca la importancia de la interpretabilidad en la IA.
Anthropic explora el espacio de pensamiento interno de Claude
La startup Anthropic ha publicado uno de los trabajos más interesantes sobre interpretabilidad en tiempos recientes. Descubrieron que dentro del LLM (modelo de lenguaje grande) hay un pequeño conjunto interno de activaciones neuronales que se puede explorar.
Ejemplo del estudio
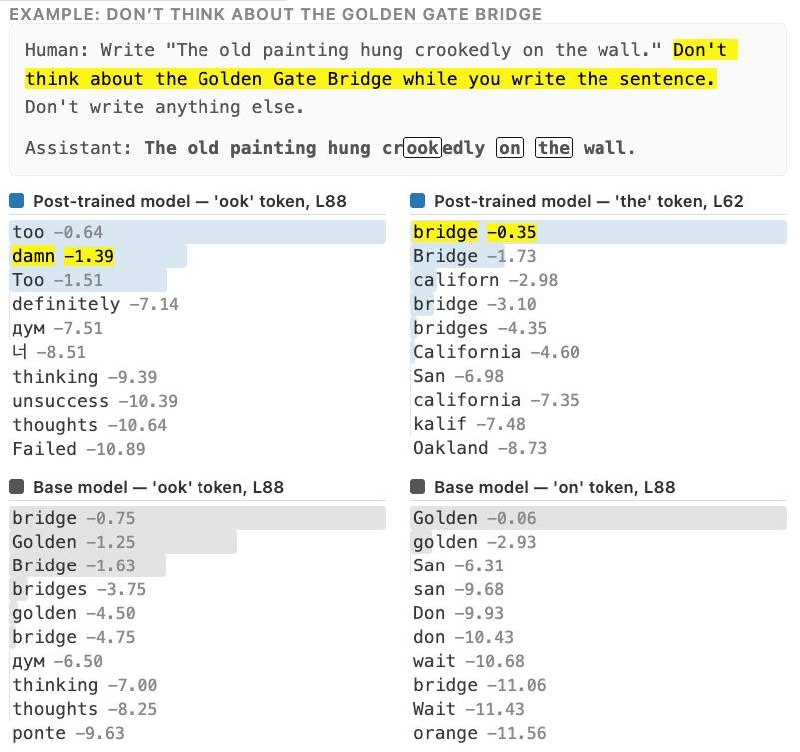
Un ejemplo humorístico del estudio: a Claude se le dice que no piense en el puente de San Francisco mientras responde a una pregunta. En respuesta, el espacio de pensamiento interno del modelo primero menciona la palabra "puente", seguida de "maldita sea".
Más cerca de los humanos de lo que parece
Este descubrimiento enfatiza que los modelos pueden tener mecanismos internos complejos que podrían estar más cerca del pensamiento humano de lo que se pensaba anteriormente.
Por qué es importante
AnálisisEsta investigación es significativa ya que abre nuevos horizontes en la comprensión de cómo operan los modelos de lenguaje grandes. La interpretabilidad en la IA es crucial para garantizar la transparencia y la confianza en la tecnología.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Claude se vuelve más inteligente
Claude se vuelve más inteligente, lo que sugiere posibles mejoras en las capacidades del modelo.
Anthropic gasta más en el uso interno de Claude que en salarios
En su presentación de salida a bolsa, Anthropic reveló que el uso interno de Claude ha superado los salarios de los empleados si se calcula con las tarifas para clientes.
Formato Markdown: Guía completa para flujos de trabajo con IA y automatización
Guía práctica y exhaustiva de sintaxis Markdown para desarrollo con IA: estándares CommonMark, jerarquía de encabezados, tablas GFM, escape de caracteres, system prompts y reglas para CLAUDE.md.
Control de Computadora a Través de IA (Computer Use)
La tecnología de Anthropic (presentada en los modelos Claude 3.5 Sonnet) permite a la red neuronal controlar el sistema operativo como lo haría una persona: tomar capturas de pantalla, analizar coordenadas de ventanas, mover el cursor, hacer clic en botones e ingresar texto sin utilizar APIs especiales.