Тір-лист ШІ-моделей: чи реальне використання за гроші точніше за бенчмарки?
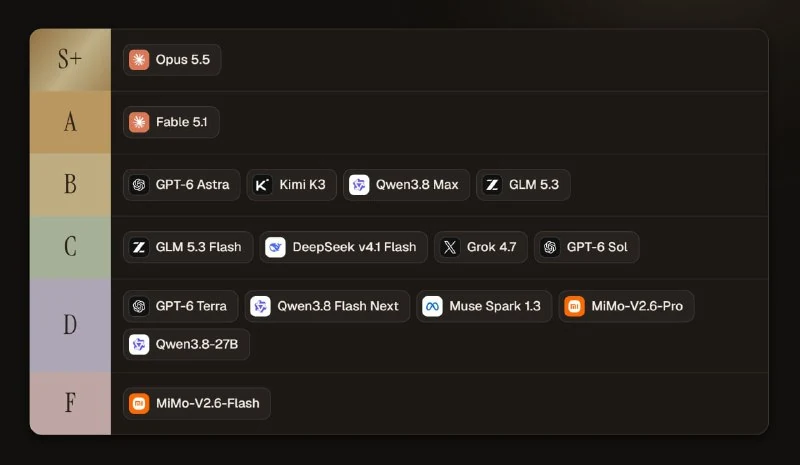
Тір-лист ШІ-моделей, побудований на реальному використанні за гроші, обговорюють як альтернативу офіційним бенчмаркам.
Тір-лист ШІ-моделей: чи реальне використання за гроші точніше за бенчмарки?
У мережі обговорюють тір-лист ШІ-моделей, який, імовірно, може бути точнішим за більшість офіційних бенчмарків.
Головна відмінність такого рейтингу — він складений не за результатами тестових завдань, а на основі реального використання моделей у платних сценаріях. Це означає, що на позиції впливають не лише синтетичні метрики, а й практична корисність, витрати та досвід роботи з сервісами.
Такий підхід викликає закономірне питання: чи є реальне використання за гроші кращим показником якості ШІ, ніж стандартні бенчмарки?
Чому це важливо
АналітикаПрактичні платні сценарії можуть показати сильніші сторони моделей, ніж синтетичні тести, але вони менш відтворювані та залежать від конкретних задач.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Qwen4-Max вийшла: на 50% менше токенів і нижча вартість задачі
Qwen4-Max отримала архітектуру MoE, контекст 1 млн токенів, вбудовану підтримку зображень та суттєво меншу витрату токенів.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?
Бенчмарки для агентів: GAIA та SWE-bench
Нове покоління суворих практичних бенчмарків для оцінки автономності штучного інтелекту. GAIA тестує мультимодальні завдання у відкритому вебі з файлами та браузером, а SWE-bench перевіряє здатність агентів знаходити та виправляти справжні баги у великих репозиторіях GitHub.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.